
Foundry IQ e SharePoint: perché i metadati cambiano le risposte della knowledge base
Foundry IQ SharePoint metadati: cosa mostra il PoC Microsoft, come usare colonne e filtri nel RAG e perché i permessi vanno progettati esplicitamente.
Tempo di lettura: 11 min
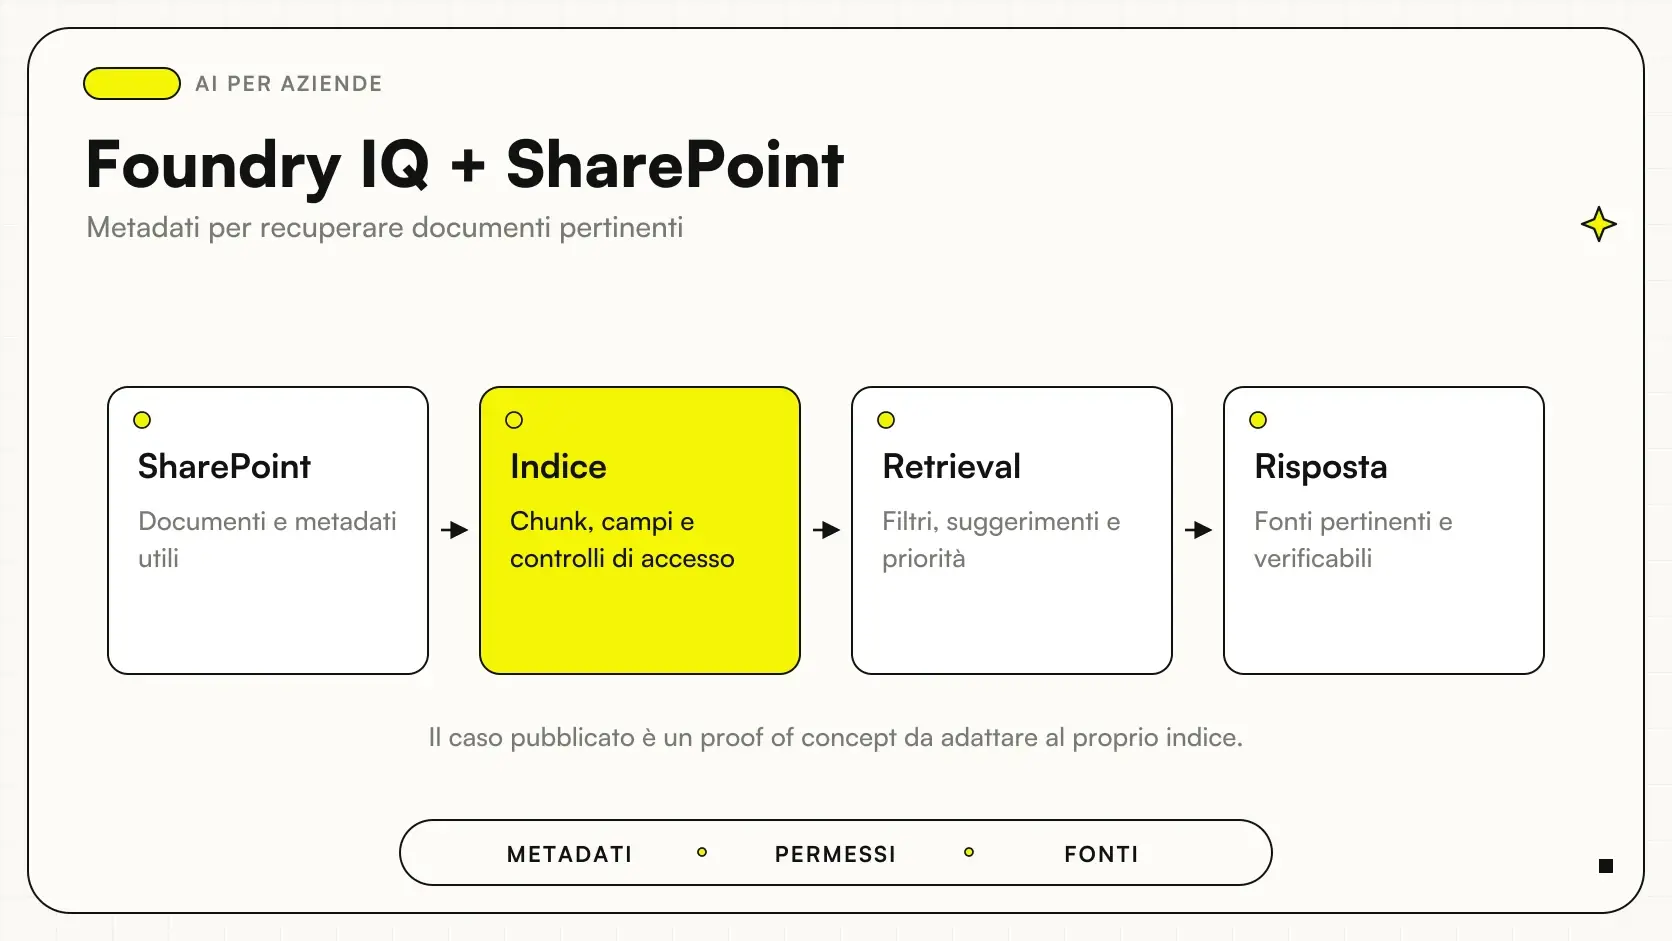
Una knowledge base può recuperare il documento sbagliato anche quando il suo testo è pertinente: il vincolo decisivo potrebbe stare nelle colonne di SharePoint. Stato, reparto o classificazione possono cambiare la risposta senza comparire nel PDF. Il PoC pubblicato da Microsoft mostra come portare queste informazioni nel recupero con Foundry IQ.
La pubblicazione dell'8 ottobre 2026 è un nuovo esempio tecnico riproducibile, non il lancio di Foundry IQ né la disponibilità generale di tutte le funzioni mostrate. Utilizza dati sintetici e illustra un indice Azure AI Search con metadati strutturati sui chunk e indicazioni al planner. PoC ufficiale Microsoft.
In sintesi
- Le colonne possono contenere vincoli che non appaiono nel testo del documento.
- Il PoC replica informazioni strutturate sui chunk per renderle utilizzabili nel recupero.
- I query hints aiutano il planner, ma richiedono compatibilità con lo schema dell'indice.
- La dimostrazione su dati sintetici non garantisce gli stessi risultati su archivi aziendali.
- Un indice personalizzato richiede una progettazione esplicita della propagazione dei permessi.
Perché cercare soltanto nel testo può essere insufficiente?
Immagina una procedura il cui testo descrive correttamente un'attività, mentre una colonna dell'archivio la indica come superata. Se la ricerca vede solo il testo, può considerarla un'ottima risposta. Lo stesso problema emerge quando una domanda riguarda un reparto o una classificazione che sono registrati fuori dal documento. Il contenuto semantico è pertinente, ma manca un vincolo che determina quale fonte sia utilizzabile.
È un problema diverso dall'allucinazione intesa come informazione inventata. Il sistema potrebbe citare un documento reale e riportarne fedelmente il contenuto, sbagliando comunque la selezione. Per questo un progetto RAG deve distinguere qualità del testo generato e qualità del recupero. Una citazione esistente non dimostra da sola che la fonte sia adatta alla domanda.
Il PoC Microsoft affronta questo livello attraverso colonne strutturate e retrieval guidato dai metadati. L'esempio utilizza report di incidenti e una tassonomia dimostrativa, con dati sintetici. Non è un archivio di clienti Giallo e non costituisce una misura universale del miglioramento ottenibile. Descrizione del dataset e dell'approccio Microsoft.
Che cosa fa concretamente il PoC Foundry IQ?
L'esempio costruisce un indice Azure AI Search nel quale le informazioni strutturate vengono replicate sui chunk, le porzioni in cui il documento viene rappresentato per il recupero. In questo modo il risultato non è soltanto un frammento di testo: porta con sé attributi che possono aiutare a selezionarlo secondo il contesto della domanda. Il repository citato da Microsoft permette di esaminare il percorso dimostrativo.
I query hints forniscono al planner indicazioni per filtri e boost. Un filtro restringe i risultati secondo un vincolo; un boost può influenzare la priorità. Queste funzioni non vanno confuse con una decisione infallibile sulla fonte corretta. Dipendono dallo schema disponibile, da ciò che la domanda richiede e dal modo in cui il sistema traduce il requisito in un'operazione di ricerca.
Il PoC usa l'API 2026-08-01-preview per i query hints. Lo stato preview e la configurazione mostrata appartengono all'esempio tecnico, non sono una garanzia di disponibilità generale del comportamento in qualsiasi ambiente. La versione e i requisiti vanno verificati nel codice del PoC prima di tentare di riprodurne il funzionamento in un progetto aziendale.
Quali colonne meritano di entrare nel recupero?
Non tutte le informazioni dell'archivio sono ugualmente utili. Conviene partire dalle domande che le persone fanno e dai vincoli che distinguono una fonte corretta da una soltanto simile. Se nessuna richiesta dipende da una colonna, includerla può aggiungere complessità senza un beneficio chiaro. Se una colonna determina validità o accessibilità, ignorarla può invece rendere il recupero inappropriato.
La tabella seguente è una proposta illustrativa, non lo schema obbligatorio del PoC. I nomi e i significati devono essere definiti sul processo dell'azienda.
| Attributo possibile | Domanda che aiuta a chiarire | Controllo sulla qualità del dato |
|---|---|---|
| Stato del documento | È una fonte approvata e utilizzabile? | Valori coerenti e gestione dei documenti ritirati |
| Reparto competente | Quale gruppo usa questa procedura? | Tassonomia condivisa fra chi pubblica e chi cerca |
| Categoria del contenuto | È un'istruzione, una nota o un precedente? | Distinzione comprensibile e applicata in modo uniforme |
| Versione o periodo di validità | Quale fonte è pertinente al caso? | Aggiornamento coordinato con la fonte |
| Identificativo del documento | Da quale originale proviene il chunk? | Collegamento stabile alla versione corretta |
| Informazioni di autorizzazione | Chi può vedere il contenuto? | Propagazione e verifica esplicita dei permessi |
Questa fase richiede il proprietario dell'archivio. Se «approvato» significa cose diverse fra reparti, il modello non può correggere da solo l'ambiguità. La progettazione della knowledge base aziendale comprende proprio la scelta delle fonti e delle responsabilità, prima dell'interfaccia conversazionale.
Perché un filtro generato può essere sbagliato?
Il planner deve produrre operazioni compatibili con i campi e i tipi dell'indice. Un nome di colonna errato, un valore non previsto o un'espressione incompatibile possono causare errori. Il PoC richiama questo confine: i query hints non eliminano la necessità di controllare lo schema e il comportamento delle query. Limiti descritti nella pubblicazione tecnica.
Anche una query formalmente valida può rappresentare male l'intenzione dell'utente. Se una persona usa un nome informale per un reparto, il sistema deve capire se esiste una corrispondenza autorizzata o se serve chiedere una precisazione. Forzare sempre un filtro può escludere la fonte giusta; non applicarlo può includere fonti che violano il vincolo della domanda.
La prova dovrebbe quindi includere richieste chiare, sinonimi, colonne mancanti e valori ambigui. Per ciascuna si annotano vincolo atteso e documenti ammissibili. Quando il risultato è vuoto, il team deve distinguere assenza di fonti, filtro eccessivo ed errore della query. «Non ho trovato niente» è un esito da interpretare, non la dimostrazione che l'archivio non contenga la risposta.
Il documento contiene la risposta, ma il sistema continua a escluderlo?
Controlla gli attributi replicati sul chunk e il filtro effettivamente generato. Verifica che nomi, tipi e valori corrispondano allo schema e che il documento sia nella versione prevista. Prima di cambiare modello, prova a capire se il recupero lo esclude per un vincolo corretto, un dato errato o una traduzione impropria della domanda.
Dal filtro pertinente al diniego verificato
Cliente e reparto aiutano il recupero, mentre l’accesso richiede un’identità e regole proprie. Il percorso knowledge base AI e permessi estende la verifica a fonti, frammenti, citazioni e revoche. Un pilot deve includere richieste non autorizzate e copie rimaste nell’indice, evitando di leggere un buon filtro semantico come prova della protezione.
I permessi SharePoint passano automaticamente nell'indice?
Un indice personalizzato richiede di progettare esplicitamente la propagazione delle autorizzazioni. Le FAQ Foundry IQ distinguono il percorso previsto per una knowledge source SharePoint remota dalla responsabilità di gestire gli accessi in altre configurazioni. Non è corretto dedurre che una copia dei contenuti e delle colonne erediti automaticamente ogni permesso. FAQ ufficiali Foundry IQ.
Nel progetto bisogna collegare identità dell'utente, autorizzazioni della fonte e risultati restituiti. Un contenuto potrebbe essere semanticamente corretto ma riservato a un altro gruppo. Il filtro di reparto usato per migliorare la pertinenza non va confuso con un controllo di sicurezza. La selezione per significato e l'autorizzazione rispondono a domande diverse e devono essere verificate separatamente.
La prova deve utilizzare utenti con accessi differenti e includere cambiamenti di autorizzazione. Si controlla cosa succede quando un documento diventa riservato o una persona cambia ruolo. L'obiettivo è evitare che il testo rimanga visibile nell'indice dopo la revoca. Le basi della sicurezza dei dati con AI sono parte della qualità del recupero: una fonte corretta mostrata alla persona sbagliata rimane un risultato inappropriato.
Una PMI manifatturiera con procedure: scenario ipotetico
Immaginiamo una PMI che conserva procedure operative in SharePoint. Alcune hanno testo simile ma riguardano reparti diversi; altre sono state ritirate e restano nell'archivio per consultazione storica. In questo scenario ipotetico la domanda «quale procedura devo usare?» non può essere risolta soltanto dalla vicinanza semantica fra domanda e testo.
La prova partirebbe da una raccolta autorizzata e da colonne con significato condiviso. Il team preparerebbe domande in cui stato e reparto cambiano la fonte corretta. Il risultato dovrebbe mostrare il documento pertinente, il collegamento all'originale e informazioni sufficienti a riconoscere la versione. Non si affiderebbe al testo generato il compito di indovinare se una procedura è ancora approvata.
Un caso essenziale sarebbe il ritiro di un documento. Dopo il cambiamento, il recupero dovrebbe riflettere il nuovo stato e non continuare a proporre chunk precedenti come istruzioni valide. Il responsabile confronterebbe fonti attese e risultati, prima di valutare la formulazione della risposta. Sarebbe un criterio più concreto della semplice presenza di una citazione, perché verifica il vincolo che rende quella citazione utilizzabile.
Uno studio con fascicoli e precedenti: scenario ipotetico
Consideriamo uno studio professionale che cerca precedenti interni, classificati per ambito e accessibilità. In questo secondo scenario ipotetico il materiale può essere utile senza essere appropriato per ogni collaboratore. La ricerca dovrebbe distinguere pertinenza del precedente e diritto di consultazione, mantenendo il collegamento al fascicolo autorizzato.
La prova utilizzerebbe materiali che lo studio può trattare e identità con permessi diversi. Alcune domande verrebbero ripetute da utenti differenti per verificare la separazione. Un precedente non accessibile non dovrebbe comparire come estratto, titolo rivelatore o fonte di una risposta. Non basterebbe impedire l'apertura del file originale se l'assistente ne ha già mostrato il contenuto.
La guida all'analisi dei documenti aziendali rimane utile per distinguere recupero e interpretazione. Trovare un fascicolo simile non significa che sia applicabile al nuovo incarico. L'interfaccia dovrebbe favorire lettura e confronto della fonte, segnalando quando un vincolo manca. Il risultato atteso sarebbe aiutare la ricerca professionale, mantenendo la decisione sul caso al referente competente.
Come si aggiornano metadati e chunk senza perdere coerenza?
Replicare gli attributi sulle porzioni di documento rende necessario mantenerli allineati. Se cambia lo stato della fonte, il progetto deve sapere come aggiornare le rappresentazioni già presenti. Se cambia un identificativo o una classificazione, deve rimanere chiaro quali risultati appartengono a quella versione. Il problema non si risolve una volta sola durante l'importazione iniziale.
Per questo conviene definire il proprietario delle colonne e il percorso degli aggiornamenti. Un errore di acquisizione dovrebbe essere visibile, così che un documento rimasto indietro non venga scambiato per una fonte corrente. La prova può includere una modifica intenzionale e il controllo del risultato successivo, osservando anche i materiali che non sono stati aggiornati correttamente.
Altre tecnologie di recupero affrontano un livello diverso. Gli embedding multimodali Perplexity per PDF e EmbeddingGemma 2 per ricerca locale interessano la rappresentazione dei contenuti. Il PoC Foundry IQ qui discusso interessa i vincoli strutturati nel recupero. Migliorare la rappresentazione di una pagina non rende automaticamente coerente una colonna che indica la validità del documento.
Che cosa succede quando una colonna è vuota o contraddittoria?
Un archivio reale può contenere documenti senza reparto, stati incoerenti o valori scritti in modi diversi. La prova deve includere questi casi, invece di usare soltanto materiali perfettamente classificati. Se una colonna determina l'ammissibilità della fonte, il sistema deve avere un comportamento concordato quando l'informazione manca: escludere il materiale, chiedere un chiarimento o segnalarlo al proprietario dell'archivio, secondo il processo previsto.
La scelta non dovrebbe essere lasciata a una deduzione invisibile. Un modello potrebbe riconoscere dal testo un reparto plausibile, ma questo non equivale a una classificazione approvata. Per i campi che governano accesso o validità, il dato esplicito e il percorso di correzione sono essenziali. Il referente deve sapere quali documenti richiedono manutenzione prima di diventare fonti affidabili.
È utile anche controllare le contraddizioni fra contenuto e colonna. Una procedura può dichiararsi aggiornata nel testo mentre l'archivio la segna come ritirata. Il progetto deve stabilire quale informazione sia autorevole e come segnalare il conflitto. Questo lavoro migliora l'archivio indipendentemente dal modello e rende più interpretabili gli errori osservati durante il recupero.
Quali errori evitare nella decisione di adozione?
Il primo è presentare il PoC come una nuova funzione già disponibile in ogni configurazione di produzione. Il secondo è trasferire i risultati su dati sintetici al proprio archivio senza prova. Il terzo è aggiungere molte colonne prima di sapere quali domande debbano risolvere. Il quarto è trattare un filtro di pertinenza come se fosse una barriera di autorizzazione.
Un altro errore sarebbe valutare soltanto la risposta finale. È necessario conservare fonti recuperate e vincoli applicati, così da spiegare perché il sistema abbia incluso o escluso un documento. Il confronto con Atlassian Rovo, Jira e Confluence riguarda un altro ecosistema, ma richiama la stessa scelta: il contesto utile deve arrivare dalle fonti corrette, con identità e permessi coerenti.
Per partire, scegli domande in cui una colonna cambia davvero la risposta e documenti che l'azienda è autorizzata a usare. Possiamo costruire una knowledge base interna con recupero e permessi verificati, confrontando fonte attesa, filtro e risultato prima di estendere l'archivio. Il valore del PoC è rendere visibile un problema preciso: spesso la risposta non manca dal documento, ma dal modo in cui il sistema decide quale documento cercare.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 RAG: cos'è e perché migliora le risposte AI
 AI per knowledge base aziendale: smetti di cercare informazioni
 AI per analizzare documenti aziendali: guida pratica
 AI e sicurezza dei dati: rischi concreti e come gestirli
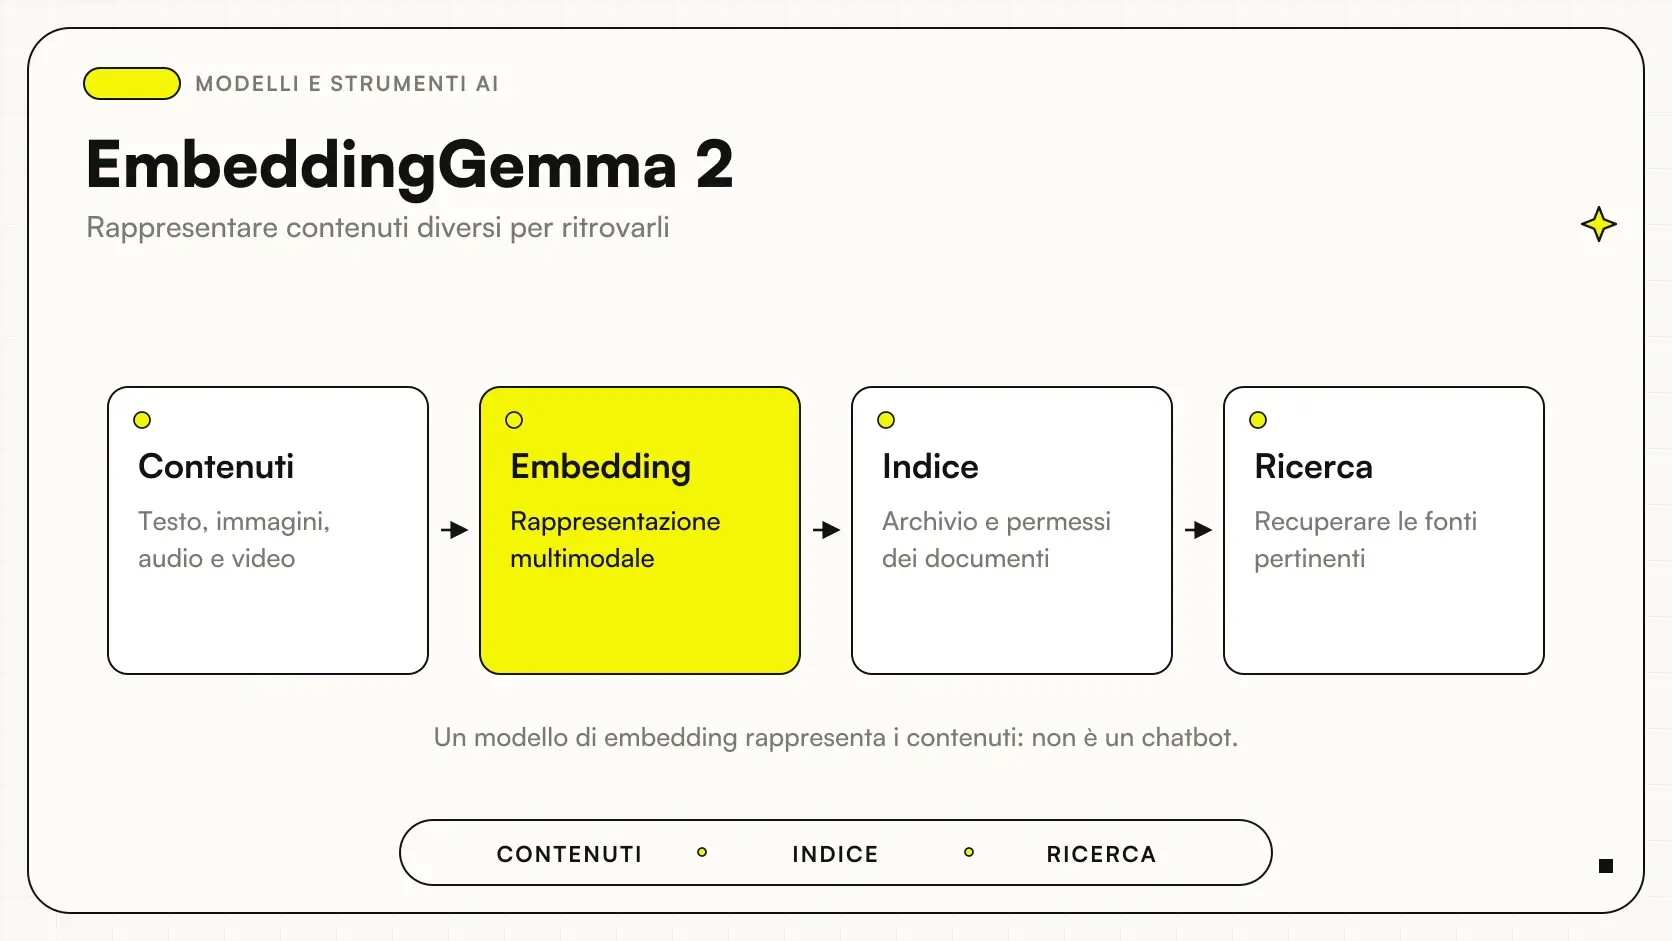 EmbeddingGemma 2: ricerca AI locale nei documenti aziendali
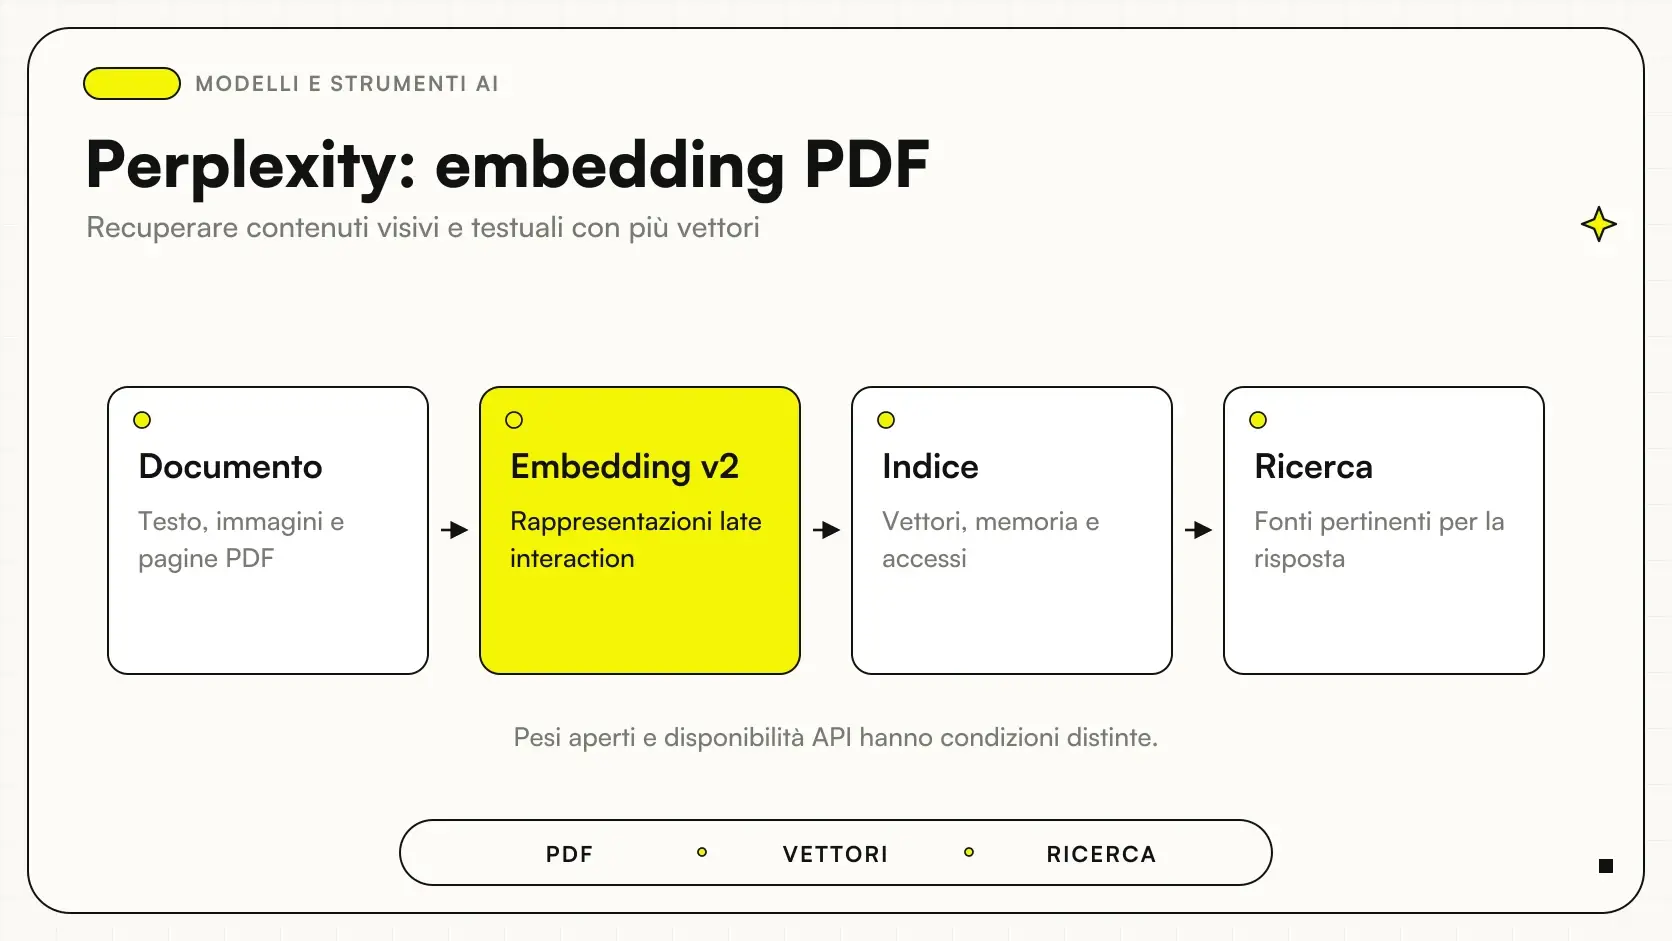 Perplexity apre i nuovi embedding multimodali: cercare anche nelle pagine PDF
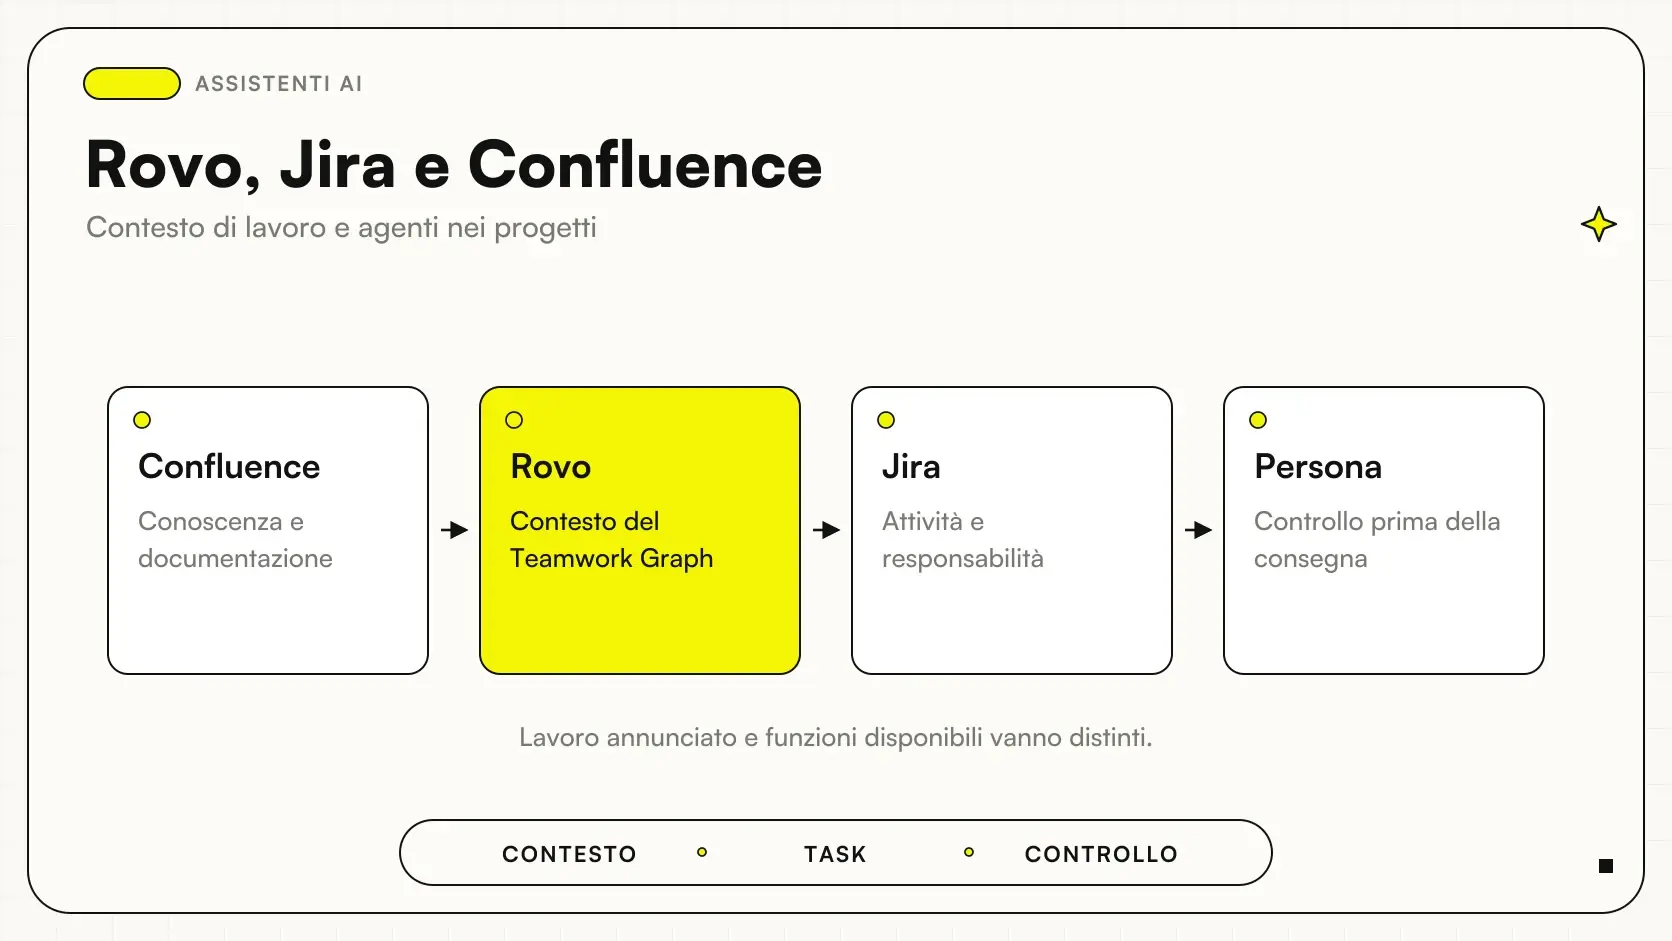 OpenAI e Atlassian ampliano Rovo: Jira e Confluence nel lavoro con l'AI
FAQ
Qual è la novità del PoC Foundry IQ?
Microsoft mostra un recupero documentale guidato dai metadati, con colonne strutturate replicate sui chunk e query hints. È una pubblicazione tecnica, non l’annuncio della disponibilità generale di ogni funzione.
Perché le colonne SharePoint contano nella ricerca AI?
Possono contenere informazioni come stato, reparto o classificazione che non compaiono nel testo del documento. Se non entrano nel recupero, la ricerca può ignorare un vincolo importante della domanda.
Il PoC usa dati di clienti reali?
L’esempio descritto usa dati sintetici e una tassonomia dimostrativa. I risultati non costituiscono una garanzia di miglioramento su un archivio aziendale diverso.
I query hints rendono sempre corretto un filtro?
No. I filtri generati devono essere compatibili con campi e tipi dell’indice. La configurazione va verificata con richieste valide, ambigue e incompatibili con lo schema.
Un indice personalizzato eredita automaticamente i permessi SharePoint?
Non va dato per scontato. Il percorso remoto previsto e un indice personalizzato hanno responsabilità diverse: per il secondo occorre progettare esplicitamente propagazione e verifica delle autorizzazioni.
Da dove iniziare una prova in azienda?
Scegli documenti autorizzati e domande che dipendono dalle colonne, non soltanto dal testo. Controlla fonti recuperate, validità dei metadati e separazione dei risultati fra utenti con permessi diversi.