
Temperatura di un modello AI spiegata in parole semplici
Che cosa significa temperatura in un modello AI, perché cambia le risposte e quando abbassarla o alzarla nel lavoro di una PMI.
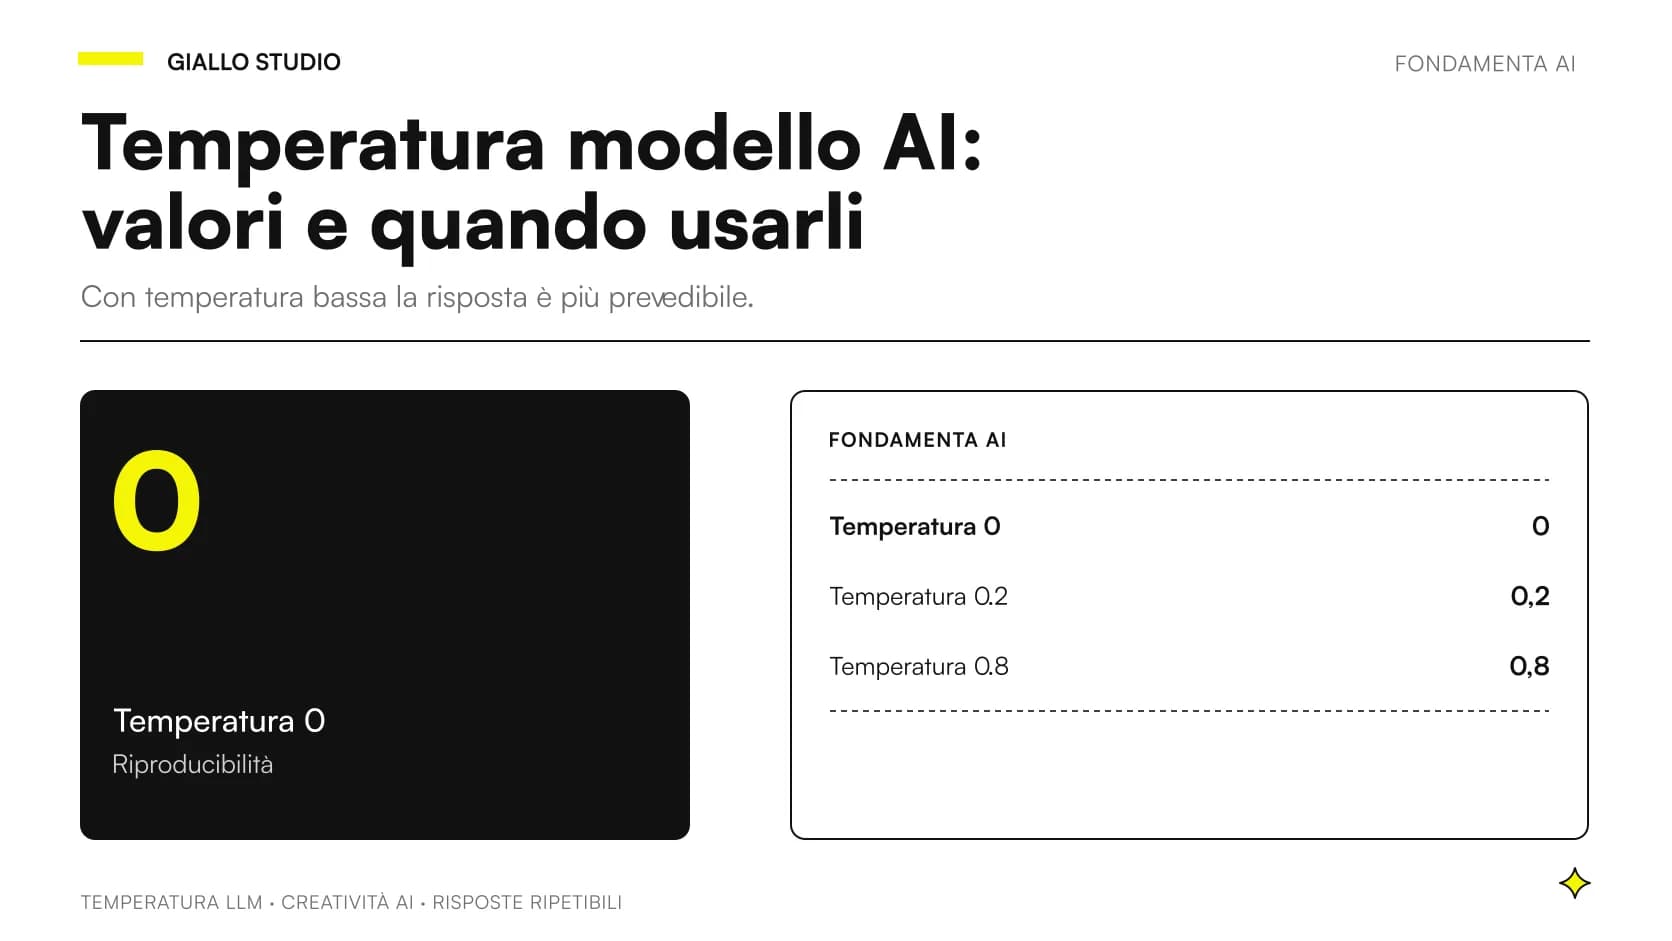
La temperatura è un parametro che regola quanto le risposte di un modello AI possono variare. Secondo il glossario di Mistral è un valore compreso tra 0.0 e 1.0 che controlla la casualità dell'output: con valori bassi il risultato è più concentrato e deterministico, con valori alti è più vario e creativo (Glossary di Mistral AI).
In pratica è una manopola. Non rende il modello più intelligente né più preciso: cambia il modo in cui sceglie, tra le possibilità che ha, quella che scrive. Per questo la stessa domanda posta due volte può ricevere due risposte diverse, e per questo conviene sapere quando tenere la manopola bassa e quando alzarla.
In questa guida spieghiamo prima l'idea, poi il meccanismo, poi cosa fare in azienda. Useremo solo ciò che dicono i glossari di Mistral e di Google e dichiareremo dove le fonti non dicono abbastanza.
In sintesi
- La temperatura controlla la casualità dell'output di un modello: più è bassa, più la risposta è focalizzata e prevedibile.
- Valori alti producono testi più vari e creativi, utili per cercare idee ma meno adatti a procedure e documenti.
- Per i compiti in cui contano coerenza e riproducibilità, il glossario di Mistral indica di impostarla a 0.
- La temperatura non garantisce che una risposta sia vera: i contenuti vanno sempre verificati prima dell'uso.
- Le fonti consegnate non dicono dove si regoli la temperatura nelle app di chat né come incida sui costi.
Che cosa significa temperatura in un modello AI?
Il glossario di Mistral la descrive come un parametro da 0.0 a 1.0 che controlla la casualità dell'output. I valori bassi, con l'esempio di 0.2, danno un risultato focalizzato e deterministico; quelli alti, con l'esempio di 0.8, danno un risultato più vario e creativo (Glossary di Mistral AI).
Il nome è una metafora presa dalla fisica, ma non serve conoscerla. Basta ricordare la direzione: verso il basso il modello è sobrio e ripetitivo, verso l'alto è più libero. Il glossario la classifica tra i concetti legati all'API, cioè tra le impostazioni che si passano quando si chiama il modello da un programma.
Un dettaglio onesto: l'intervallo da 0.0 a 1.0 è quello indicato da questo glossario. Altri fornitori possono usare scale diverse, e le fonti che abbiamo letto non riportano il valore predefinito. Prima di copiare un numero da una guida all'altra, controlla la documentazione dello strumento che usi.
Perché la stessa domanda può dare risposte diverse?
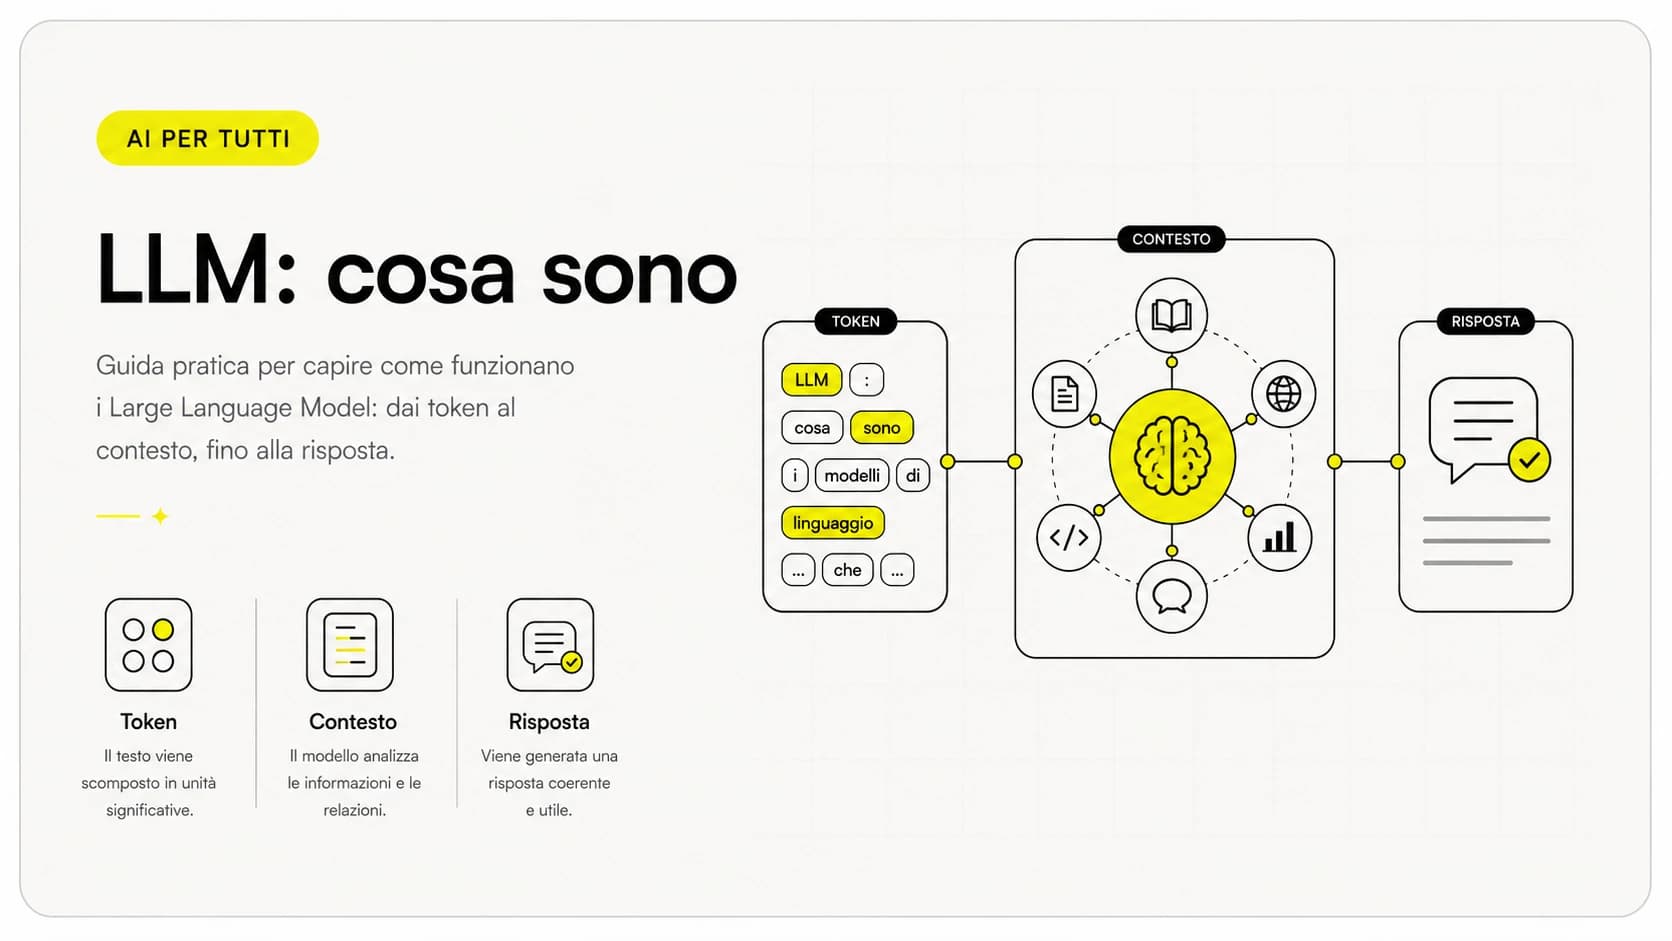
Per capirlo serve il meccanismo. Un modello linguistico genera il testo un pezzo alla volta: il glossario di Google spiega che un modello auto-regressivo prevede il token successivo sulla base dei token già previsti, e che tutti i grandi modelli linguistici basati su Transformer sono auto-regressivi (Machine Learning Glossary di Google).
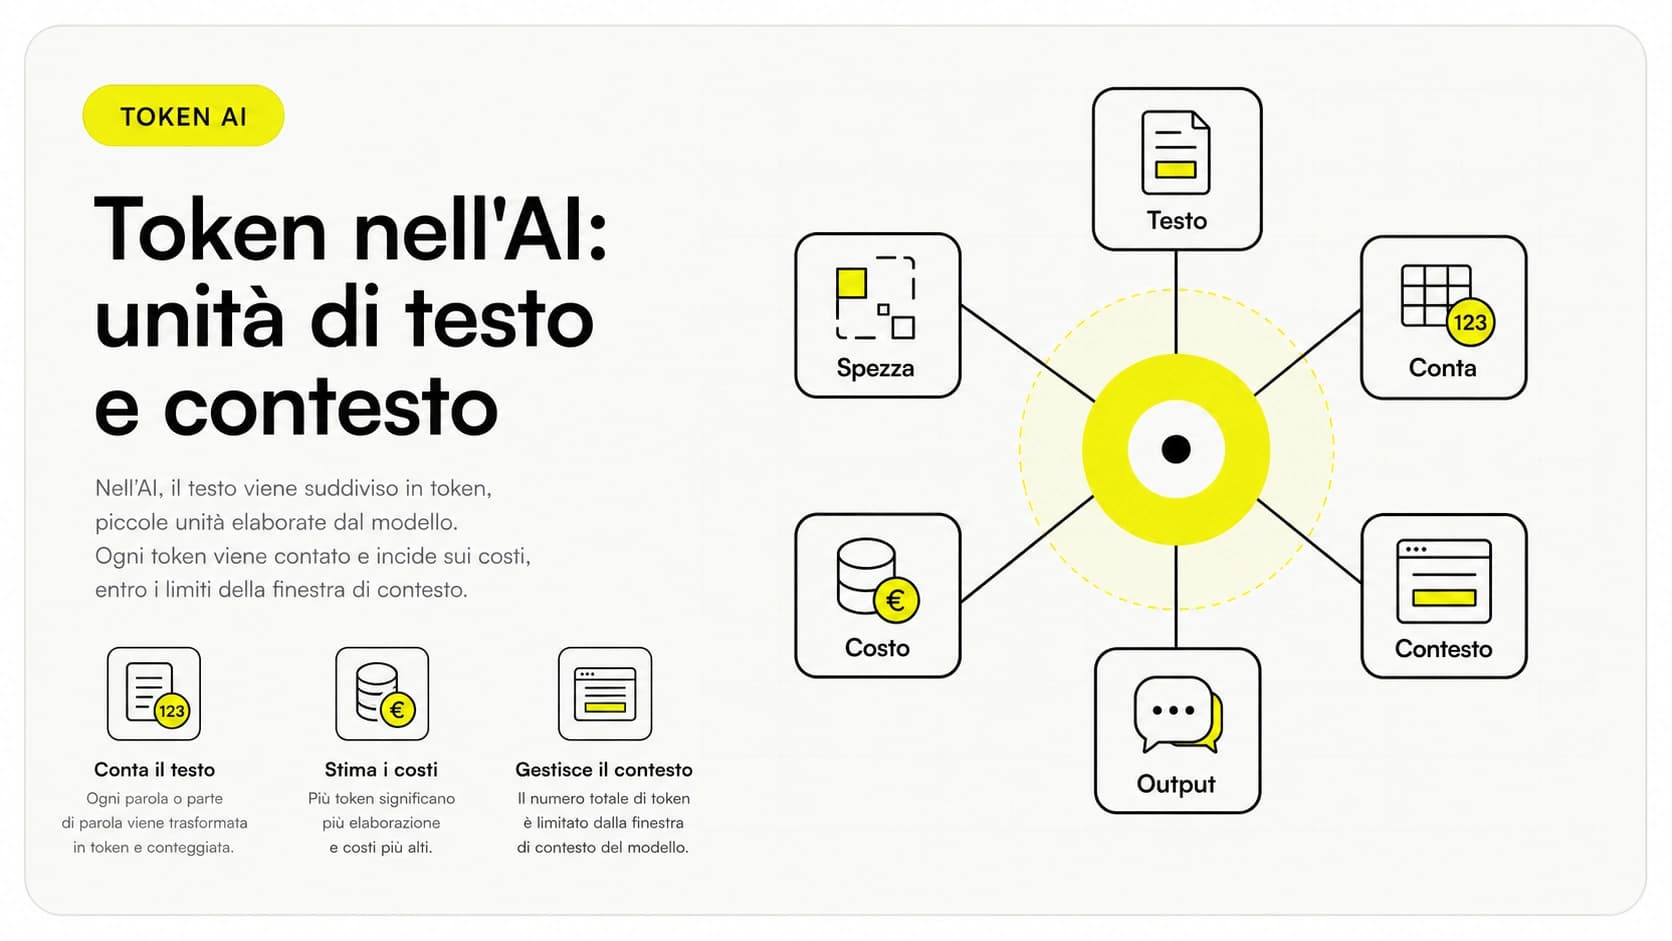
Il token, secondo Mistral, è l'unità di base del testo che i modelli elaborano: frammenti di parola, non parole intere (Glossary di Mistral AI). Se vuoi approfondire il concetto, abbiamo spiegato cosa sono i token e come si contano in un articolo dedicato.
A ogni passo il modello ha più candidati possibili per il frammento successivo. Qui entra la temperatura: decide quanto il modello si attiene al candidato più probabile e quanto invece lascia spazio agli altri. Questa è una nostra spiegazione del ruolo del parametro, coerente con la definizione di casualità dell'output, non una citazione.
Un'analogia, dichiarata come tale: immagina una persona che completa una frase. Con temperatura bassa sceglie quasi sempre la parola più ovvia; con temperatura alta ogni tanto pesca una parola meno scontata. L'analogia semplifica, ma rende l'idea del perché due risposte possono differire.
C'è poi il momento in cui tutto questo accade. Il glossario di Mistral chiama inferenza l'esecuzione di un modello addestrato per generare una risposta: chiamare l'API significa fare inferenza, cosa distinta dall'addestramento, che modifica i pesi del modello (Glossary di Mistral AI). La temperatura agisce quindi quando il modello risponde, non quando impara.
Per inquadrare meglio questi modelli puoi leggere cosa sono gli LLM e come si collocano rispetto al deep learning spiegato in modo semplice.
Come cambia il comportamento con valori diversi?
La tabella riassume ciò che le fonti dicono sui valori indicati come esempio. Non sono soglie universali: sono i valori citati dal glossario.
| Valore | Cosa produce | Quando ha senso | Fonte |
|---|---|---|---|
| 0 | Coerenza e riproducibilità | Compiti in cui servono sempre risultati simili | Mistral |
| 0.2 | Output focalizzato e deterministico | Procedure, risposte standard, documenti | Mistral |
| 0.8 | Output più vario e creativo | Ricerca di idee, varianti di testo | Mistral |
La colonna «Quando ha senso» è la nostra lettura applicativa dei fatti, non una raccomandazione dei glossari. Il glossario di Mistral dice espressamente di impostare 0 per i compiti in cui coerenza e riproducibilità sono critiche (Glossary di Mistral AI).
Attenzione. Una temperatura bassa rende la risposta più ripetibile, non più corretta. Un modello può ripetere con coerenza anche un errore: per questo la verifica resta necessaria, come spieghiamo in una checklist per controllare le risposte dell'AI prima di usarle.
Quando conviene abbassare la temperatura?
Quando il risultato deve essere prevedibile. Il glossario di Mistral lo dice chiaramente: per i compiti dove coerenza e riproducibilità sono fondamentali, il valore va impostato a 0 (Glossary di Mistral AI).
Traducendo in lavoro quotidiano, sono i casi in cui chi legge si aspetta sempre la stessa forma e lo stesso contenuto: una risposta a una domanda ricorrente, il riassunto di una procedura, la compilazione di una scheda con campi fissi. Qui la varietà non è un pregio, è un rischio, perché due clienti potrebbero ricevere formulazioni diverse della stessa regola.
Un altro vantaggio è pratico. Se il risultato è riproducibile, è più facile provare una modifica al prompt e capire se è stata la modifica a cambiare la risposta, e non il caso. Questo vale in particolare quando lavori sulla scrittura delle istruzioni: il glossario di Google ricorda che il prompt engineering è cruciale per guidare i modelli e prevede metodi come zero-shot, one-shot e few-shot (Machine Learning Glossary di Google). Per esercitarti, trovi la nostra guida completa ai prompt.
Quando ha senso alzarla?
Quando cerchi varietà. Per il glossario di Mistral, valori alti come 0.8 producono un output più vario e creativo (Glossary di Mistral AI).
Il glossario di Google va nella stessa direzione da un'altra parte: osserva che è facile supporre che tutti i modelli debbano basarsi sulla fattualità, ma alcuni prompt devono spingere un modello generativo a ottimizzare la creatività anziché la fattualità (Machine Learning Glossary di Google). Lo stesso glossario definisce la fattualità come la proprietà di un modello il cui output è basato sulla realtà, precisando che è un concetto e non una metrica.
Per un'azienda questo significa che non esiste un valore giusto in assoluto: dipende dal compito. Cercare dieci nomi per una nuova linea di prodotti è un lavoro diverso dal rispondere a una domanda sui termini di una garanzia. Nel primo caso la varietà aiuta; nel secondo fa danni.
Quali esempi concreti ci sono per una PMI?
I due esempi seguenti sono ipotetici e servono a illustrare il ragionamento: non sono casi di clienti e non riportano risultati misurati.
Uno studio professionale che prepara risposte standard. Immagina un piccolo studio che usa l'AI per bozze di email ai clienti su scadenze e documenti da inviare. Il testo deve essere sempre coerente con le procedure dello studio. Qui la scelta ragionevole è una temperatura bassa, secondo l'indicazione di coerenza e riproducibilità del glossario di Mistral (Glossary di Mistral AI). Ogni bozza va comunque riletta da una persona prima dell'invio.
Un negozio online che cerca idee per le descrizioni. Immagina un piccolo e-commerce che vuole proporre tre o quattro varianti di titolo per una scheda prodotto. Qui una temperatura più alta ha senso, perché l'obiettivo è la varietà: lo stesso glossario associa i valori alti a un output più creativo (Glossary di Mistral AI). Le varianti sono spunti, non testi da pubblicare senza controllo: prezzi, materiali e caratteristiche vanno verificati sui dati reali.
In entrambi i casi la stessa tecnologia viene usata con impostazioni opposte. Per altri scenari di lavoro puoi guardare la guida su AI per PMI.
Quali errori evitare con la temperatura?
Pensare che temperatura bassa significhi risposte vere
Succede perché «deterministico» suona come «affidabile». In realtà il parametro riguarda la casualità, non la correttezza. Il glossario di Google tratta la fattualità come un concetto distinto, che non è una metrica (Machine Learning Glossary di Google). Si evita controllando sempre i contenuti, e ricordando che il rischio di errori inventati è trattato in Allucinazioni AI: cosa sono e come evitarle.
Usare una temperatura alta per testi che devono essere precisi
Si fa per rendere i testi «meno robotici». Il prezzo è la variabilità: due risposte alla stessa domanda possono contraddirsi. Si evita riservando i valori alti alle fasi creative e usando valori bassi per procedure, dati e documenti.
Cambiare più impostazioni insieme
Succede quando si prova a migliorare un risultato toccando temperatura e istruzioni nello stesso momento. Non si capisce più cosa abbia funzionato. Si evita cambiando una cosa alla volta e annotando l'effetto.
Dare per scontato che il numero valga ovunque
Il glossario indica l'intervallo da 0.0 a 1.0, ma altri fornitori possono usare scale diverse e le fonti non indicano il valore predefinito (Glossary di Mistral AI). Si evita leggendo la documentazione dello strumento e provando i valori su esempi reali.
Come applicarlo in azienda, passo dopo passo?
- Elenca i compiti in cui usi l'AI e dividili in due gruppi: quelli che richiedono sempre lo stesso risultato e quelli in cui cerchi varietà.
- Per il primo gruppo parti da una temperatura bassa, fino a 0 dove coerenza e riproducibilità sono critiche, come indica il glossario di Mistral.
- Per il secondo gruppo prova valori più alti e tratta le uscite come spunti da selezionare, non come testi finali.
- Fai le prove con gli stessi esempi reali, cambiando un solo parametro per volta, e conserva le risposte per confrontarle.
- Fai controllare i contenuti a una persona prima di usarli con clienti o in documenti ufficiali.
Una parte pratica resta fuori dai fatti: le fonti non dicono in quali app di chat la temperatura sia regolabile, perché il glossario di Mistral la colloca tra i concetti API. Se usi uno strumento già pronto, verifica nelle impostazioni o chiedi al fornitore. Non è invece verificato se la temperatura influisca su costi o lunghezza delle risposte: il glossario collega il prezzo API al numero di token, ma non dice nulla sul ruolo della temperatura (Glossary di Mistral AI).
Se poi lavori con documenti lunghi, ricorda il limite della finestra di contesto: per Mistral è il numero massimo di token che un modello elabora in una singola richiesta, tra input e output, e quando viene superato i contenuti precedenti vengono scartati (Glossary di Mistral AI). Per capire come i modelli rappresentano il significato dei testi puoi leggere anche Embedding AI: cosa sono.
Cosa può farci un'azienda con tutto questo?
La temperatura è una delle leve più semplici da capire e più utili da governare. Una PMI può usarla per rendere prevedibili le attività ripetitive e per tenere uno spazio creativo controllato dove serve, senza cambiare strumento. Il passo successivo è decidere quali compiti affidare all'AI e con quali controlli.
Se vuoi ragionare su dove l'AI ha senso nella tua attività e con quali impostazioni, puoi partire dalla nostra consulenza AI.
Metodo e fonti delle guide di Giallo Studio
Vuoi applicarlo alla tua azienda?In 30 minuti, gratis: il processo da automatizzare per primo e il ritorno stimato, per iscritto.
Prenota l’audit gratuitoCome lo applichiamo in azienda
Risorse correlate
FAQ
Che cos'è la temperatura in un modello AI?
È un parametro che controlla la casualità dell'output. Con valori bassi le risposte sono più focalizzate e deterministiche, con valori alti diventano più varie e creative. Non cambia le conoscenze del modello, ma il modo in cui sceglie cosa scrivere.
Perché ChatGPT o altri assistenti danno risposte diverse alla stessa domanda?
I modelli generano il testo un pezzo alla volta, prevedendo il token successivo a partire da quelli già prodotti. Quando c'è casualità nella scelta, le risposte possono differire. Le fonti consegnate non dicono quali impostazioni usi ciascuna app.
Una temperatura bassa elimina gli errori?
No. Rende il risultato più coerente e ripetibile, ma non lo rende vero. La fattualità è un concetto diverso dalla casualità, quindi i contenuti vanno controllati comunque prima di usarli.
Quale temperatura conviene per testi creativi?
Per cercare varietà e idee sono indicati valori più alti, che producono un output più creativo. Le uscite vanno trattate come spunti da selezionare e verificare. Il valore esatto dipende dallo strumento e dalla sua scala.
Posso regolare la temperatura in una normale chat AI?
Le fonti che abbiamo letto non lo dicono: il glossario la tratta come concetto legato all'API. In una chat già pronta l'impostazione potrebbe non essere disponibile o avere un altro nome. Conviene controllare le impostazioni dello strumento o la sua documentazione.
La temperatura cambia i costi di utilizzo?
Le fonti consegnate non lo dicono, quindi non possiamo affermarlo. Sappiamo solo che il numero di token determina il prezzo dell'API e il consumo della finestra di contesto. Per i costi reali serve guardare il listino del fornitore.