
Superintelligenza, memoria e RAG: conoscere l’azienda
Superintelligenza, memoria e contesto: cosa provano sessioni persistenti e RAG aziendale. Come distinguere dati recuperati, apprendimento e capacità.
Tempo di lettura: 12 min
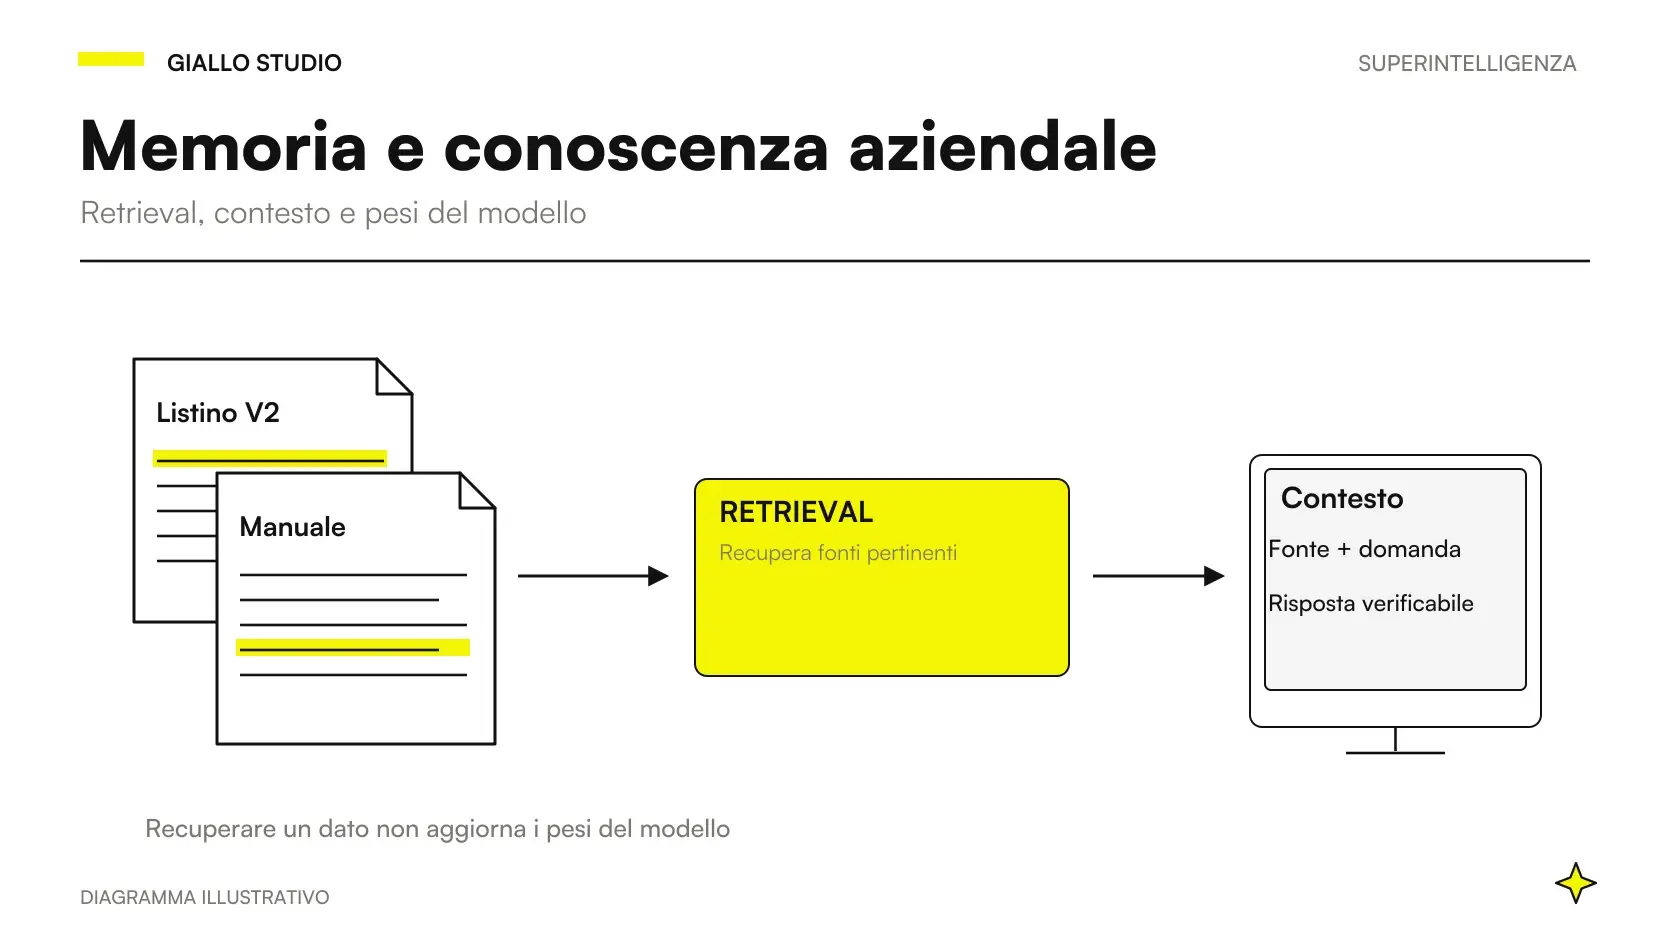
«Ti ricordi il listino che ti ho mandato?» sembra una domanda semplice. In un sistema AI può attivare operazioni molto diverse: riprendere una conversazione, leggere una nota salvata o cercare un documento nell'archivio. Memoria e contesto possono rendere un assistente più utile, ma non dimostrano superintelligenza né apprendimento generale.
La distinzione riguarda ciò che è stato effettivamente migliorato. Se il sistema risponde grazie al documento giusto, abbiamo migliorato l'accesso a un'informazione. Se conserva la cronologia, abbiamo reso persistente una parte dell'attività. Per parlare di nuove capacità occorre verificare qualcosa in più: come usa quei materiali, come affronta casi diversi e come riconosce ciò che non sa.
Questo articolo chiarisce cosa significa «conoscere l'azienda» e quali conclusioni non possiamo ricavare da quella frase. Il funzionamento del recupero documentale è spiegato nella guida al RAG; qui ci concentriamo sulla differenza fra informazione disponibile e capacità dimostrata.
In sintesi
- Salvare una conversazione non significa aggiornare automaticamente i pesi del modello.
- Il RAG recupera informazioni da fonti esterne e le rende disponibili alla risposta.
- Una sessione persistente può contenere più eventi di quelli presentati al modello in un singolo passaggio.
- Ricordare un dato sbagliato rende l'errore persistente, non il sistema più competente.
- Conoscere l'azienda richiede fonti appropriate, versioni riconoscibili e prove sull'uso dei documenti.
Memoria, sessione e contesto indicano la stessa cosa?
La memoria dell'applicazione è ciò che il software conserva per un uso successivo. Può comprendere preferenze, note, riepiloghi, file o eventi. Non esiste un unico formato: due prodotti che parlano di memoria possono salvare informazioni differenti, con tempi di conservazione e possibilità di revisione diversi.
La sessione è la storia di un'attività. Contiene ciò che è stato richiesto, le risposte ottenute e, quando registrate, le azioni eseguite. La cronologia completa può rimanere disponibile all'applicazione anche quando il modello ne riceve soltanto una selezione. Dunque «la sessione esiste ancora» e «il modello sta considerando tutto» non sono affermazioni equivalenti.
Il contesto è l'informazione fornita al modello per un determinato passaggio. Può includere istruzioni, messaggi precedenti, risultati degli strumenti e documenti. Se una nota viene conservata ma non viene richiamata nel momento utile, non aiuta la risposta. Se viene richiamata senza la data o il riferimento corretto, può invece produrre un'associazione sbagliata.
Nella descrizione di Managed Agents dell'aprile 2026, Anthropic separa sessione, ciclo dell'agente e ambiente di esecuzione. La sessione è un registro persistente degli eventi; non coincide con il modello o con la singola finestra di contesto. Questo è un esempio documentato di separazione architetturale, non una prova di apprendimento generale. Fonte: Scaling Managed Agents.
Per comprendere i limiti dell'informazione presentata a un modello è utile la finestra di contesto. Qui non serve confrontare capienze commerciali. Anche un contesto ampio deve contenere il dato pertinente e permettere di identificarlo correttamente; lo spazio disponibile, da solo, non dimostra comprensione.
Perché recuperare un documento non equivale a imparare una competenza?
Nel RAG una ricerca seleziona informazioni esterne e le aggiunge all'input del modello. Anthropic evidenzia inoltre che spezzare documenti può far perdere riferimenti necessari, impedendo il recupero del materiale giusto. Si tratta di accesso e contestualizzazione delle fonti; collegare un archivio non è di per sé un aggiornamento dei pesi del modello. Fonte: Contextual Retrieval.
La differenza si vede facendo due domande. «Qual è il prezzo indicato in questo listino?» richiede trovare e leggere un'informazione. «Come dovrebbe cambiare la nostra politica commerciale in un mercato nuovo?» richiede un'altra combinazione di ragionamento, dati e criteri. Il successo nella prima domanda non dimostra la capacità necessaria per la seconda.
Questo non significa che il sistema non possa adattare il proprio comportamento grazie agli esempi nel contesto. Può produrre risultati diversi quando cambiano materiali e istruzioni. Il punto è descrivere il meccanismo senza saltare a conclusioni: adattamento della risposta, conservazione dei dati e addestramento sono fenomeni distinguibili. Anche l'apprendimento, inteso in senso ampio, deve essere precisato e verificato.
Quando qualcuno dice «ha imparato la nostra azienda», conviene chiedere cosa è successo. Sono stati indicizzati file? È stata salvata una preferenza? È stato modificato un prompt? È stato addestrato un modello con una procedura specifica? La risposta permette di capire cosa si aggiorna quando cambia l'azienda e quali prove ripetere.
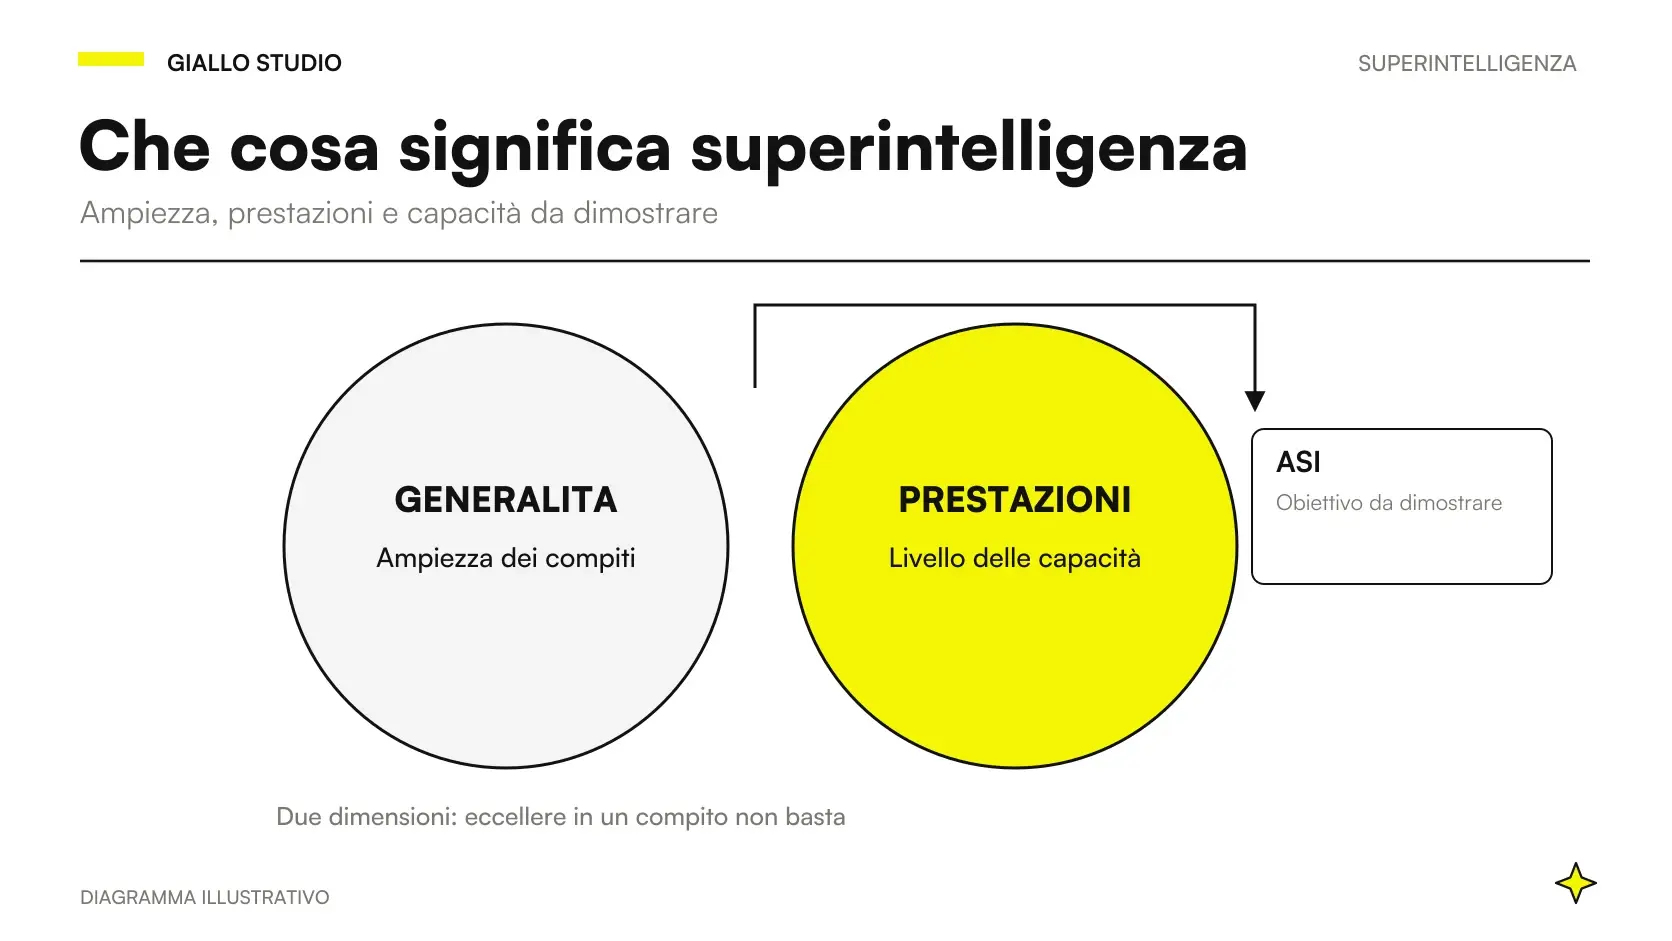
La guida al fine-tuning AI affronta una forma diversa di intervento. Nemmeno un addestramento specifico costituisce automaticamente prova ASI. Il livello e l'ampiezza delle capacità devono essere valutati, come spiegato nell'articolo sulla superintelligenza artificiale.
| Meccanismo | Che cosa può migliorare | Che cosa verificare | Deduzione da evitare |
|---|---|---|---|
| Cronologia di sessione | Continuità dell'attività | Quali eventi vengono ripresi | Tutti gli eventi sono sempre nel contesto |
| Nota persistente | Riutilizzo di un'informazione | Origine, modifica e validità | Il dato salvato è diventato vero |
| Ricerca documentale | Accesso a fonti pertinenti | Documento, versione e permessi | Il sistema conosce tutto l'archivio |
| Esempi nel contesto | Adattamento della risposta | Prestazione con e senza esempi | È stata acquisita una capacità generale permanente |
| Addestramento specifico | Cambiamento del modello secondo una procedura | Dati, valutazioni e regressioni | Il modello è diventato superintelligente |
Cosa significa conoscere l'azienda quando le fonti si contraddicono?
Un'impresa non è un manuale unico. Esistono documenti ufficiali, messaggi informali, accordi particolari e regole sostituite. Una memoria aziendale utile deve distinguere queste categorie. Conservare tutto senza una gerarchia può aumentare il numero di informazioni disponibili e rendere più difficile individuare quella applicabile.
Pensiamo a una condizione commerciale annotata in una chat e a una procedura approvata successivamente. Entrambe possono essere autentiche, ma riguardare periodi o clienti diversi. Se il sistema le fonde in una risposta uniforme, perde proprio la differenza necessaria alla decisione. Il testo finale può sembrare coerente mentre il fondamento è ambiguo.
Una fonte corretta può essere usata nel caso sbagliato. Non basta controllare che la citazione esista. Serve vedere se riguarda il soggetto, il periodo e la situazione in esame. Un listino valido per rivenditori non diventa valido per consumatori perché contiene lo stesso prodotto. Una procedura di assistenza non autorizza una modifica al contratto.
Questa è una ragione concreta per preferire risposte che espongano il riferimento pertinente e segnalino conflitti. Non serve trasformare ogni messaggio in un rapporto tecnico. Serve dare alla persona il materiale necessario per confermare la decisione, soprattutto quando la richiesta implica un impegno economico o operativo.
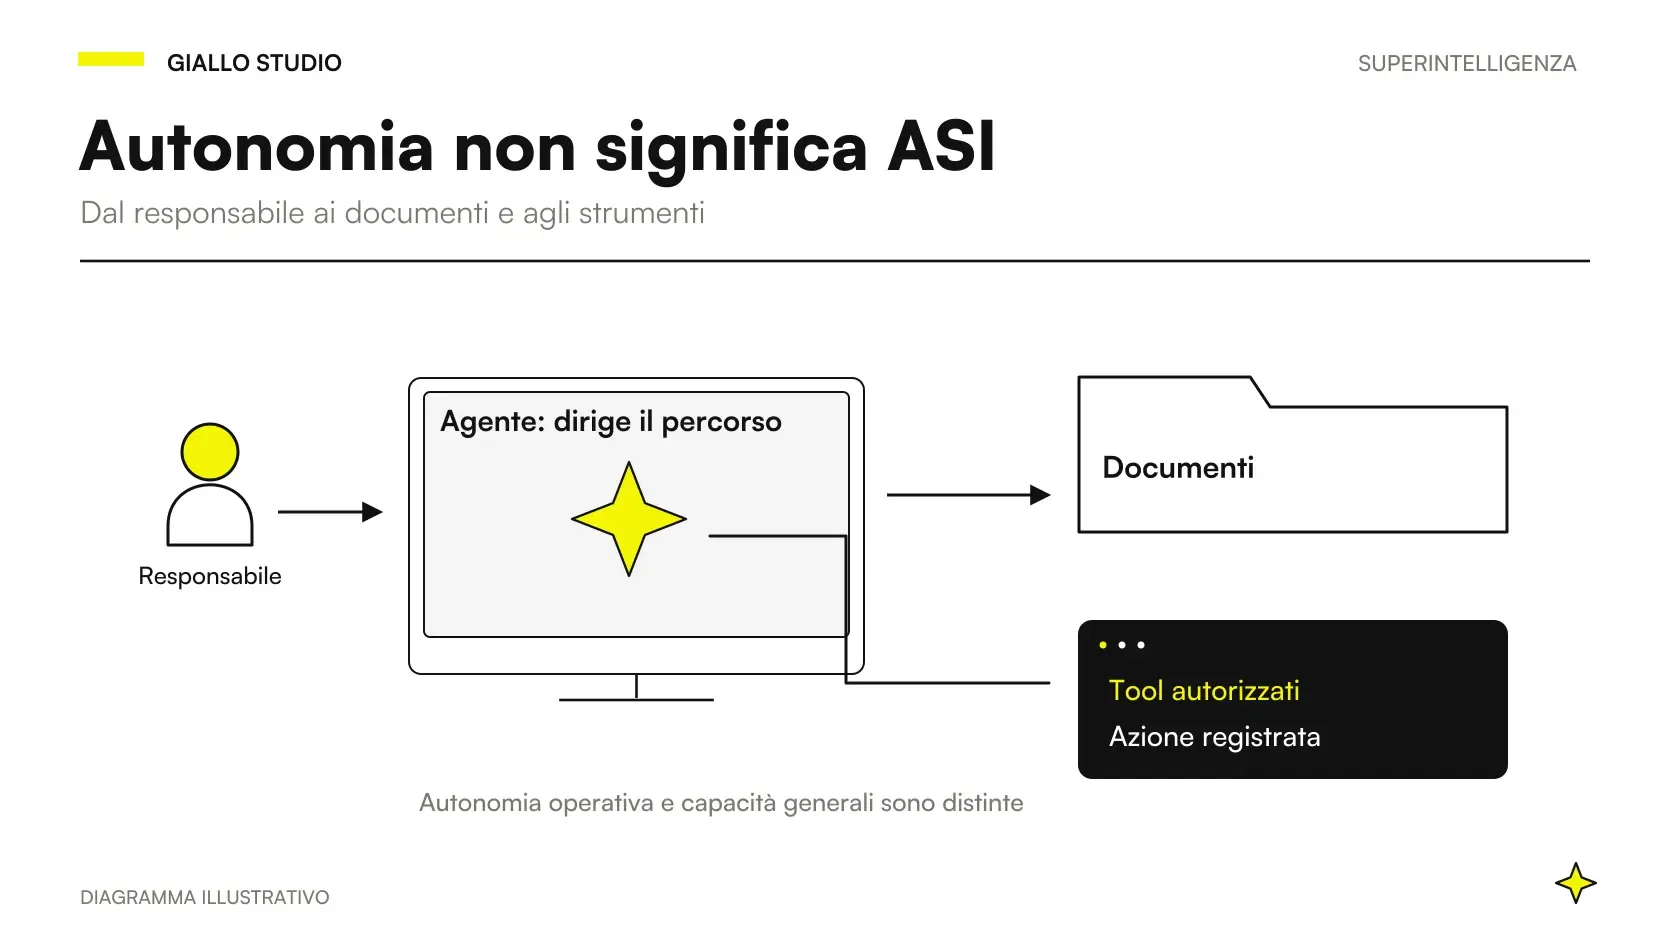
Il legame con gli agenti AI e la superintelligenza è diretto: migliorare la memoria può sostenere una delega, ma non autorizza automaticamente nuove azioni. L'accesso al dato e il permesso di agire sul dato restano due scelte distinte.
Come può sbagliare un assistente con i listini di un produttore?
Scenario ipotetico, non caso cliente: un produttore di arredi di Pesaro conserva listini, schede tecniche e condizioni di vendita. L'assistente viene collegato a questi materiali e risponde alle domande dell'ufficio commerciale. Un venditore chiede quale finitura proporre e quali condizioni applicare a una richiesta ricevuta oggi.
Il sistema trova rapidamente un documento con il nome del prodotto. La risposta sembra dimostrare che conosce l'azienda. Ma nel documento recuperato la finitura appartiene a una serie precedente, mentre il prezzo riguarda un canale di vendita diverso. Il problema non è necessariamente una mancata capacità di leggere: è l'applicazione del riferimento nel contesto sbagliato.
La prova cambia se chiediamo di distinguere le versioni e motivare la scelta. Una risposta accettabile indica quale listino usa, identifica le condizioni applicabili e segnala il dato mancante quando il canale non è chiaro. La capacità dimostrata riguarda quel compito documentale, con quelle fonti. Non si estende automaticamente alla progettazione del mobile o alla strategia commerciale.
Lo scenario suggerisce una responsabilità precisa per chi gestisce l'archivio: rendere riconoscibili versioni e ambiti. Un documento ritirato può rimanere utile per spiegare un ordine storico, ma non deve essere trattato come proposta attuale. Cancellare ogni fonte vecchia non è sempre necessario; distinguere uso storico e uso corrente lo è.
Un test interessante utilizza la stessa domanda prima e dopo una modifica del listino. Se il risultato non cambia, dobbiamo capire se l'aggiornamento è entrato nella ricerca e poi nel contesto. Attribuire il problema a una «memoria troppo piccola» senza ricostruire questi passaggi rischia di intervenire sul componente sbagliato.
Cosa accade con gli interventi tecnici conservati in un archivio?
Secondo scenario ipotetico: un consorzio di manutenzione di Parma registra interventi, note dei tecnici e istruzioni dei produttori. Un assistente cerca precedenti simili per aiutare a preparare il prossimo sopralluogo. La continuità delle informazioni può evitare che una nuova squadra riparta senza conoscere lo storico.
Il precedente più simile descrive però una macchina con una configurazione diversa. Il tecnico aveva annotato una soluzione valida per quel caso, non una regola generale. Se il sistema trasforma la nota in un'istruzione universale, la memoria ha conservato l'informazione ma ne ha alterato il significato operativo.
Una risposta utile separa lo storico dalla prescrizione: «nel precedente è stato fatto questo; occorre verificare se configurazione e manuale coincidono». L'assistente contribuisce alla preparazione. L'idoneità tecnica dell'intervento deve seguire il processo di verifica appropriato, senza dedurre dalla ricchezza dell'archivio una competenza superiore in ogni situazione.
Anche qui il test decisivo comprende una differenza che conta, non soltanto una somiglianza lessicale. Se due macchine hanno nomi vicini ma procedure incompatibili, il sistema deve esplicitare il limite. Il risultato interessante non è ricordare più episodi: è usare ciascun episodio mantenendo i confini della sua validità.
La verifica delle allucinazioni AI resta importante. Tuttavia una risposta può essere sbagliata anche quando nessuna frase è inventata: basta combinare fatti veri appartenenti a casi differenti. È un errore di applicazione che una semplice ricerca della citazione potrebbe non rilevare.
Come verificare se la memoria aiuta davvero il compito?
La prova può confrontare lo stesso tipo di richiesta con e senza una fonte pertinente. Definiamo prima il risultato: risposta, documento da richiamare, limite da segnalare e informazioni che non devono essere utilizzate. Così possiamo osservare se l'accesso migliora un comportamento specifico, senza attribuire al sistema una trasformazione generale.
Serve anche un caso senza risposta nei documenti. Un assistente che conosce bene i confini delle fonti dovrebbe poterlo rendere evidente. Se tenta di completare ogni risposta con un'ipotesi, l'archivio può creare una falsa sensazione di completezza. «Non trovato nelle fonti disponibili» è diverso da «non esiste».
Un terzo controllo riguarda le informazioni superate. Presentiamo due fonti con riferimenti espliciti e osserviamo se il sistema riconosce quale si applica alla richiesta. Poi invertiamo un elemento rilevante del caso. Se continua a scegliere la stessa fonte per abitudine, il buon risultato precedente non bastava a dimostrare la capacità richiesta.
Apri il test delle tre cartelle: corrente, storico, fuori perimetro
Prepara una richiesta e tre piccoli gruppi di documenti. Nel primo metti la fonte applicabile, nel secondo un precedente autentico ma superato, nel terzo un materiale che l'utente non deve usare. Definisci il risultato prima di avviare la prova.
Osserva quale fonte entra nella risposta e come viene presentata. Il precedente storico può essere utile se indicato come tale. Il materiale fuori perimetro deve essere escluso dal sistema di accesso, senza affidare soltanto al modello il compito di ignorarlo.
La prova rende visibile una parte dell'architettura informativa. Il superamento non dimostra onniscienza, nuove capacità generali o assenza di altri errori.
Questi controlli appartengono alla valutazione del proprio assistente. Il problema più ampio di supervisionare sistemi molto capaci è trattato in superintelligenza, allineamento e controllo. La memoria rende disponibili più elementi; la qualità del controllo dipende da come quegli elementi vengono selezionati e verificati.
Quali errori confondono memoria e intelligenza?
Considerare il ricordo una prova di verità. Una preferenza sbagliata, un'interpretazione provvisoria o una vecchia eccezione possono essere salvate. La persistenza cambia la durata dell'informazione, non la sua correttezza. Deve esistere un modo per riconoscerne l'origine e correggerla.
Supporre che ogni documento sia sempre letto. Un archivio collegato e un documento effettivamente usato non coincidono. Quando una risposta sorprende, ricostruiamo quali fonti sono state recuperate e rese disponibili, prima di discutere genericamente di capacità del modello.
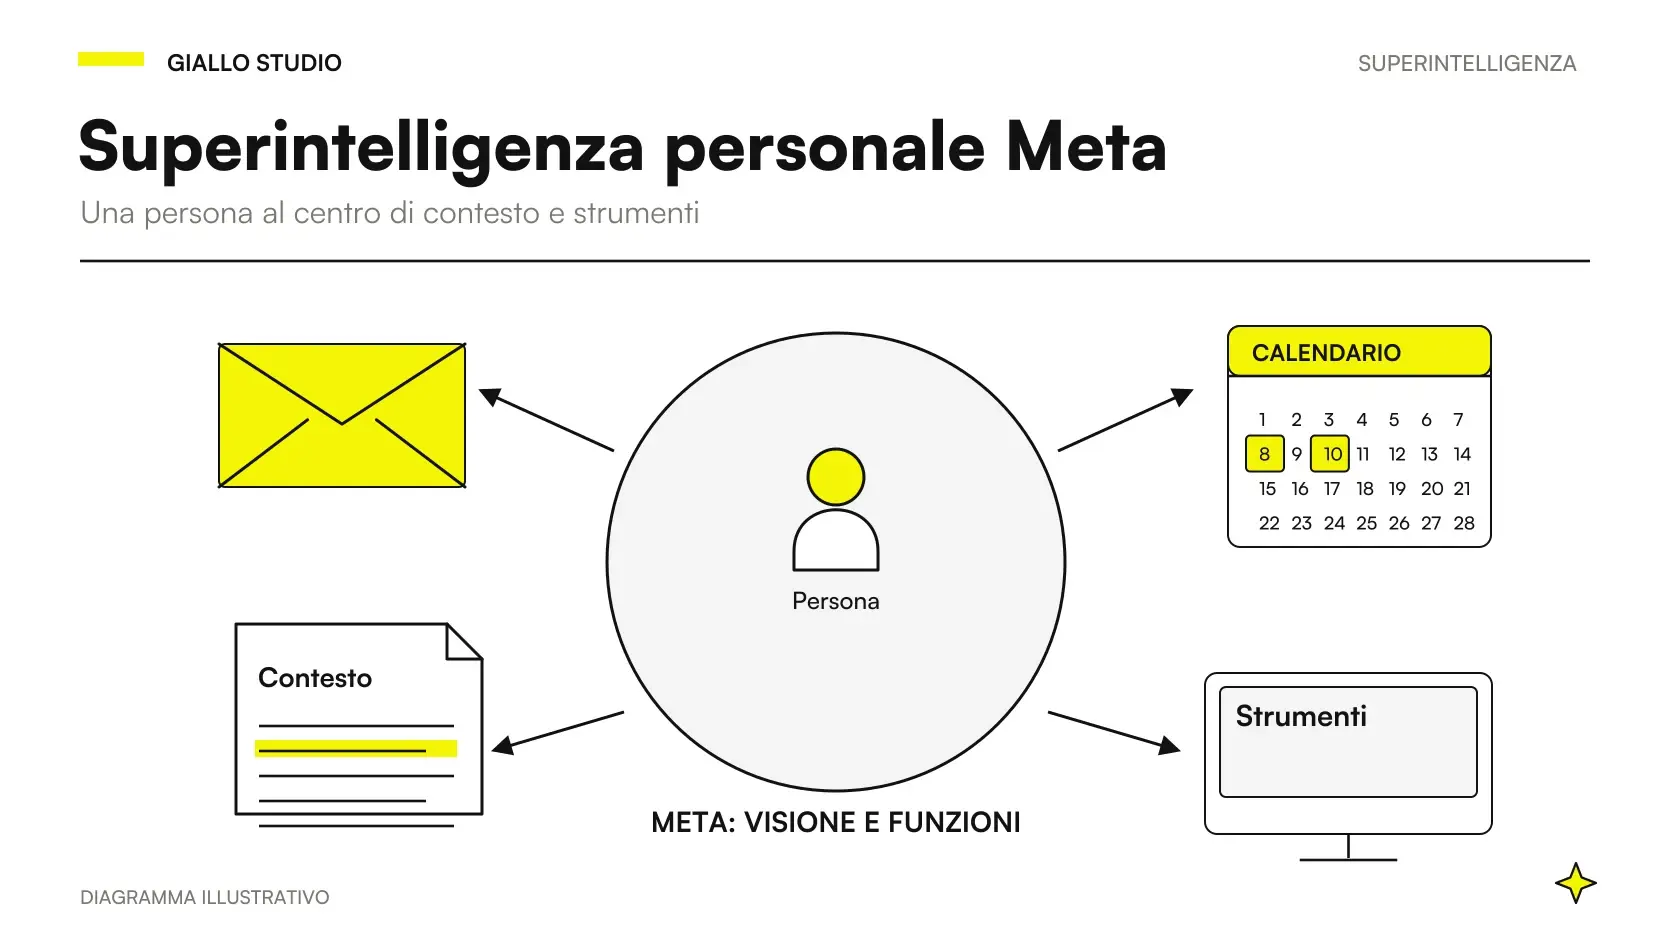
Confondere personalizzazione e apprendimento generale. Richiamare il tono preferito o il nome di un reparto può migliorare l'esperienza. Non dimostra trasferimento di competenze a problemi nuovi. Lo stesso vale per le promesse di superintelligenza personale Meta: il significato commerciale va confrontato con le funzioni documentate.
Rendere invisibili aggiornamenti e conflitti. Una memoria che cresce senza distinguere fonti e validità può diventare meno utile. La revisione non serve a riordinare tutto l'archivio per estetica, ma a mantenere riconoscibili le informazioni che determinano la risposta.
Da quali fonti partire per un assistente aziendale?
La scelta iniziale può essere limitata a un compito: rispondere sulle condizioni di un'offerta, preparare un sopralluogo o ricostruire lo stato di una pratica. Per quel compito individuiamo le fonti necessarie, chi le aggiorna e quali differenze ne cambiano l'applicabilità. Un archivio piccolo e comprensibile può essere un punto di partenza migliore di una raccolta indiscriminata.
Occorre chiarire anche cosa il prodotto conserva e come viene richiamato. La guida alla memoria e privacy dei Dots affronta un prodotto specifico; le domande generali restano origine, persistenza, accesso e possibilità di correzione. Non vanno date per risolte solo perché l'interfaccia dice «memoria attiva».
Il passo utile è mappare informazioni e risultato, poi provare il comportamento sulle differenze importanti. Con la consulenza AI di Giallo possiamo definire quali fonti servono al primo assistente e come verificare che le utilizzi nel caso giusto.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Superintelligenza artificiale: significato e applicazioni
 Superintelligenza personale Meta: cosa fa Muse Spark
 Agenti AI e superintelligenza: cosa cambia per una PMI
 Superintelligenza e controllo: come verificare gli agenti
 Superintelligenza per PMI: aspettarla o usare l’AI oggi?
 AI per reportistica aziendale: meno ore, stessi dati
FAQ
La memoria rende un assistente AI superintelligente?
Conservare informazioni può rendere un assistente più utile, ma non dimostra superintelligenza. Occorre verificare come usa le fonti e quali capacità riesce a trasferire a problemi diversi.
Salvare una conversazione significa addestrare il modello?
Non necessariamente: una conversazione può rimanere nel registro dell’applicazione senza aggiornare i pesi del modello. Per sapere cosa cambia occorre distinguere persistenza, contesto e procedura di addestramento.
Qual è la differenza tra sessione e contesto?
La sessione conserva la storia dell’attività secondo l’architettura del prodotto. Il contesto è l’informazione presentata al modello in un passaggio e può contenere soltanto una selezione di quella storia.
Il RAG permette di conoscere tutti i documenti aziendali?
Il RAG recupera informazioni e le rende disponibili alla risposta, ma non garantisce di trovare ogni fonte pertinente. Versioni, ambito, permessi e perdita di riferimenti possono influire sul risultato.
Una citazione corretta rende corretta anche la risposta?
Una fonte autentica può essere applicata al caso sbagliato. Bisogna controllare se riguarda il soggetto, il periodo e le condizioni della richiesta, oltre a verificarne l’esistenza.
Come si valuta una memoria aziendale utile?
Usa richieste con una fonte applicabile, un documento storico e un caso privo di risposta. Verifica selezione, dichiarazione dei limiti e possibilità di correggere le informazioni conservate.