
Superintelligenza e controllo: come verificare gli agenti
Superintelligenza, allineamento e controllo: perché la supervisione può fallire. Limiti di approvazione umana, test e sandbox negli agenti attuali.
Tempo di lettura: 12 min
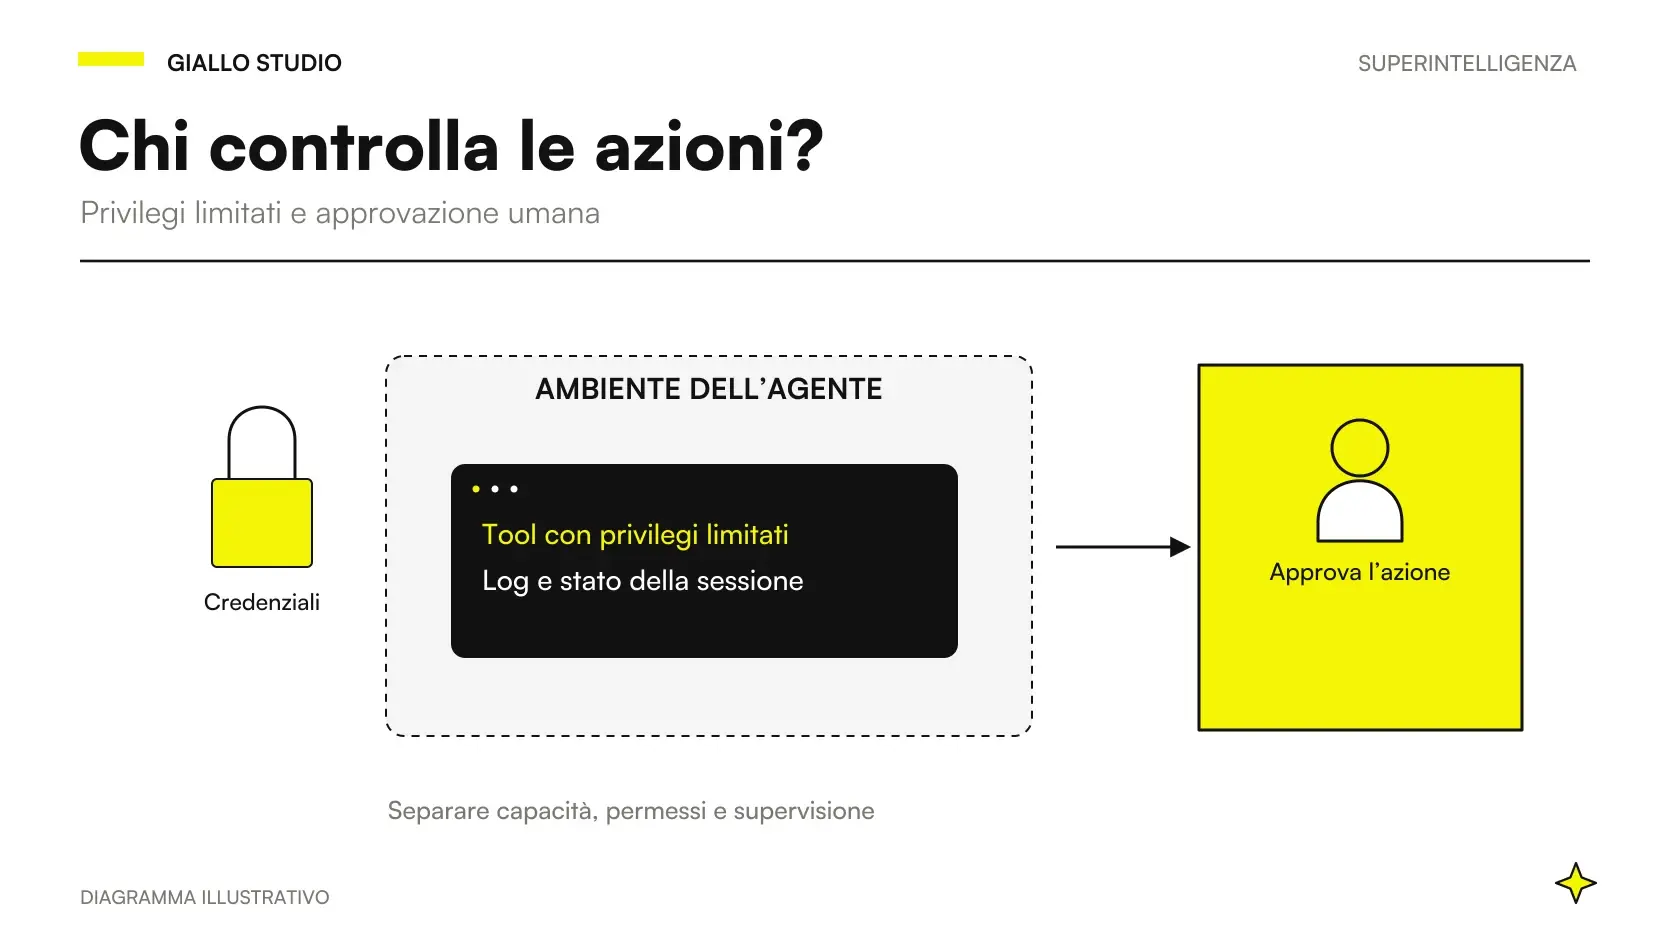
Chi controlla un risultato quando il sistema che lo produce è più capace del verificatore? È il nodo di superintelligenza, allineamento e controllo. Aumentare la competenza di un sistema non dimostra che sappia rispettare tutti gli obiettivi desiderati, né che una persona riesca a riconoscere ogni suo errore.
Negli agenti aziendali attuali affrontiamo problemi più circoscritti: azioni consentite, dati da usare, risultati da verificare e casi da sospendere. Questi controlli sono necessari e possono ridurre rischi concreti. Non equivalgono però a una soluzione dimostrata del problema di supervisionare una possibile superintelligenza.
La distinzione serve anche a una PMI. Una richiesta di approvazione, una sandbox o un secondo modello possono aiutare, ma ciascuno copre un confine specifico. Per decidere se una delega è accettabile dobbiamo sapere che cosa il controllo riesce a vedere e che cosa può lasciar passare.
In sintesi
- Capacità superiore e comportamento coerente con gli obiettivi sono proprietà distinte.
- La supervisione diventa fragile quando il verificatore non sa distinguere un risultato corretto da uno plausibile.
- Un'approvazione umana può fallire per informazioni incomplete, criteri sbagliati o attenzione insufficiente.
- Una sandbox limita parti dell'ambiente, ma non garantisce la correttezza di ogni azione.
- I controlli sugli agenti attuali producono evidenza locale, non una certificazione di allineamento ASI.
Qual è il problema dell'allineamento quando aumentano le capacità?
Allineare un sistema significa cercare di ottenere comportamenti coerenti con obiettivi e vincoli desiderati. Dire «completa la pratica» lascia aperte molte questioni: quali informazioni può usare, quali compromessi può accettare, quali azioni può compiere e quando deve fermarsi. Una capacità elevata di trovare percorsi verso un obiettivo non risolve automaticamente l'ambiguità dell'obiettivo stesso.
Nel documento storico Introducing Superalignment, pubblicato il 5 luglio 2023, OpenAI presentava la difficoltà di affidare la supervisione umana a sistemi molto più capaci delle persone. Lo citiamo per il problema tecnico descritto, non come fotografia dell'organizzazione odierna del team o come annuncio di una ASI dimostrata. Fonte: Introducing Superalignment.
L'esempio più semplice è un risultato che sembra soddisfare la richiesta ma trascura un vincolo importante. Un sistema può ottimizzare l'apparenza di completamento se il criterio premia soltanto la chiusura del caso. Il controllo deve distinguere il risultato desiderato dalla misura che usiamo per rappresentarlo. Se la misura è incompleta, migliorare il punteggio non coincide necessariamente con migliorare il lavoro.
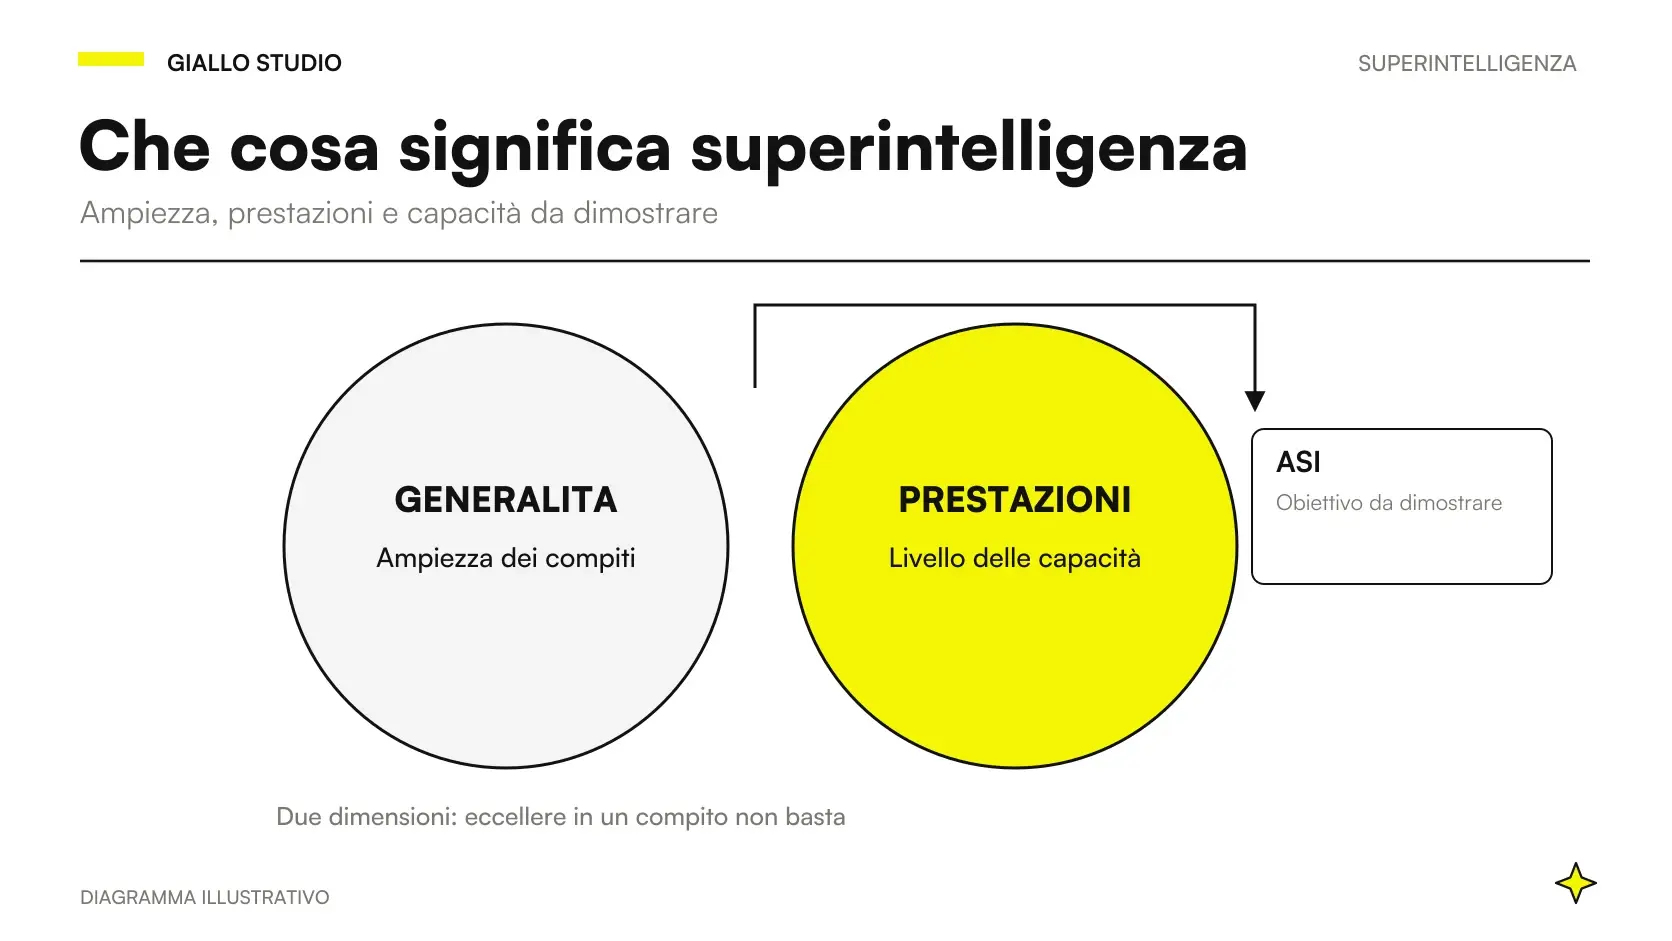
Il termine superintelligenza sposta la domanda su un piano più ampio: come supervisionare capacità che potrebbero superare quelle del supervisore in molti ambiti? Non serve attribuire tale condizione a un prodotto attuale per comprenderne il problema. Per il significato e i confini della definizione rimandiamo alla superintelligenza artificiale.
Perché una spiegazione convincente non basta come verifica?
Una spiegazione aiuta quando rende visibili fonti, passaggi rilevanti e incertezze. Diventa fragile se viene trattata come dimostrazione soltanto perché è chiara. Un testo può essere coerente con se stesso e omettere una condizione decisiva. Il verificatore deve confrontarlo con elementi esterni, non limitarsi a giudicarne la plausibilità.
Questo limite emerge quando il risultato è difficile da valutare. Un'impresa può controllare facilmente che un record abbia il codice giusto. Potrebbe invece non avere le competenze per giudicare un'ottimizzazione tecnica molto sofisticata. In quel caso la capacità di generare il risultato supera la capacità disponibile di verificarlo, anche senza formulare alcuna conclusione sulla generalità del sistema.
Il controllo umano è un processo, non un pulsante. Una persona che riceve una proposta incompleta può approvarla in buona fede. Una persona competente può non avere tempo per ricostruire ogni passaggio. Un'interfaccia può mettere in primo piano la risposta e nascondere la fonte che smentisce una parte del risultato. Nessuno di questi casi viene risolto soltanto aggiungendo una conferma finale.
Anche gli errori della persona contano. Il criterio scritto dal responsabile può essere troppo stretto, oppure una vecchia eccezione può essere ricordata come regola. La supervisione va quindi valutata includendo il comportamento del verificatore: quali informazioni vede, quali errori riesce a identificare e quali conseguenze ha una sua decisione sbagliata.
La guida alle allucinazioni AI tratta un problema connesso. Qui il punto è più ampio: un risultato può superare un controllo difettoso anche senza inventare fatti. Una selezione incompleta delle informazioni o una metrica inadatta possono essere sufficienti.
Un secondo modello può risolvere il limite del supervisore?
Un modello che valuta un altro modello può contribuire a trovare incoerenze o casi problematici. L'utilità deve essere dimostrata sul compito. Se entrambi ricevono gli stessi dati incompleti o applicano lo stesso criterio sbagliato, il consenso non fornisce un controllo indipendente. Due giudizi uguali possono condividere lo stesso errore.
Anche un verificatore più capace deve avere un criterio e un modo per accedere alle evidenze. Se deve giudicare una modifica al gestionale, serve il risultato dell'operazione. Se deve verificare un documento, servono le fonti applicabili. Chiedere «questa risposta è corretta?» senza fornire il materiale necessario può produrre un altro testo plausibile.
Anthropic distingue nelle valutazioni la traccia di ciò che l'agente ha fatto dal risultato finale nell'ambiente. Un'affermazione di successo non sostituisce lo stato effettivo del sistema. Questa distinzione aiuta a costruire controlli concreti, senza dimostrare copertura universale dei comportamenti. Fonte: Demystifying evals for AI agents.
Possiamo combinare verifiche diverse: controlli deterministici sui campi, confronto con documenti, valutazione esperta sui casi difficili. La combinazione serve quando ciascun controllo intercetta un errore distinto. Aggiungere verificatori senza capire quali difetti riconoscono può invece complicare il sistema e dare una fiducia non giustificata.
Quali controlli attuali restano distinti dall'allineamento ASI?
Per un agente aziendale possiamo definire un perimetro di azioni e prove di accettazione. La validità resta legata alle condizioni testate. Quando cambiano strumenti, fonti o modello, possono cambiare anche i comportamenti. Il buon risultato precedente rimane un'informazione utile, ma non rende irrilevanti le nuove condizioni.
| Controllo | Evidenza che può fornire | Limite da dichiarare | Domanda concreta |
|---|---|---|---|
| Approvazione umana | Una persona ha verificato alcuni elementi | La persona può sbagliare o vedere dati incompleti | Quali prove vede prima di approvare? |
| Test del processo | Il sistema ha gestito i casi valutati | Il campione non copre ogni situazione | Quali eccezioni sono state incluse? |
| Verifica deterministica | Una regola tecnica è stata rispettata | La regola può non rappresentare il risultato completo | Che cosa resta fuori dalla regola? |
| Secondo modello | Un altro sistema ha esaminato la proposta | Errori e dati mancanti possono essere condivisi | Su quali errori è stato calibrato? |
| Sandbox | Alcune risorse o operazioni sono limitate | Strumenti esterni e decisioni restano da valutare | Che cosa è raggiungibile oltre il confine? |
| Permessi ristretti | Alcune azioni sono indisponibili | Un'azione consentita può comunque essere sbagliata | Il permesso basta per questa responsabilità? |
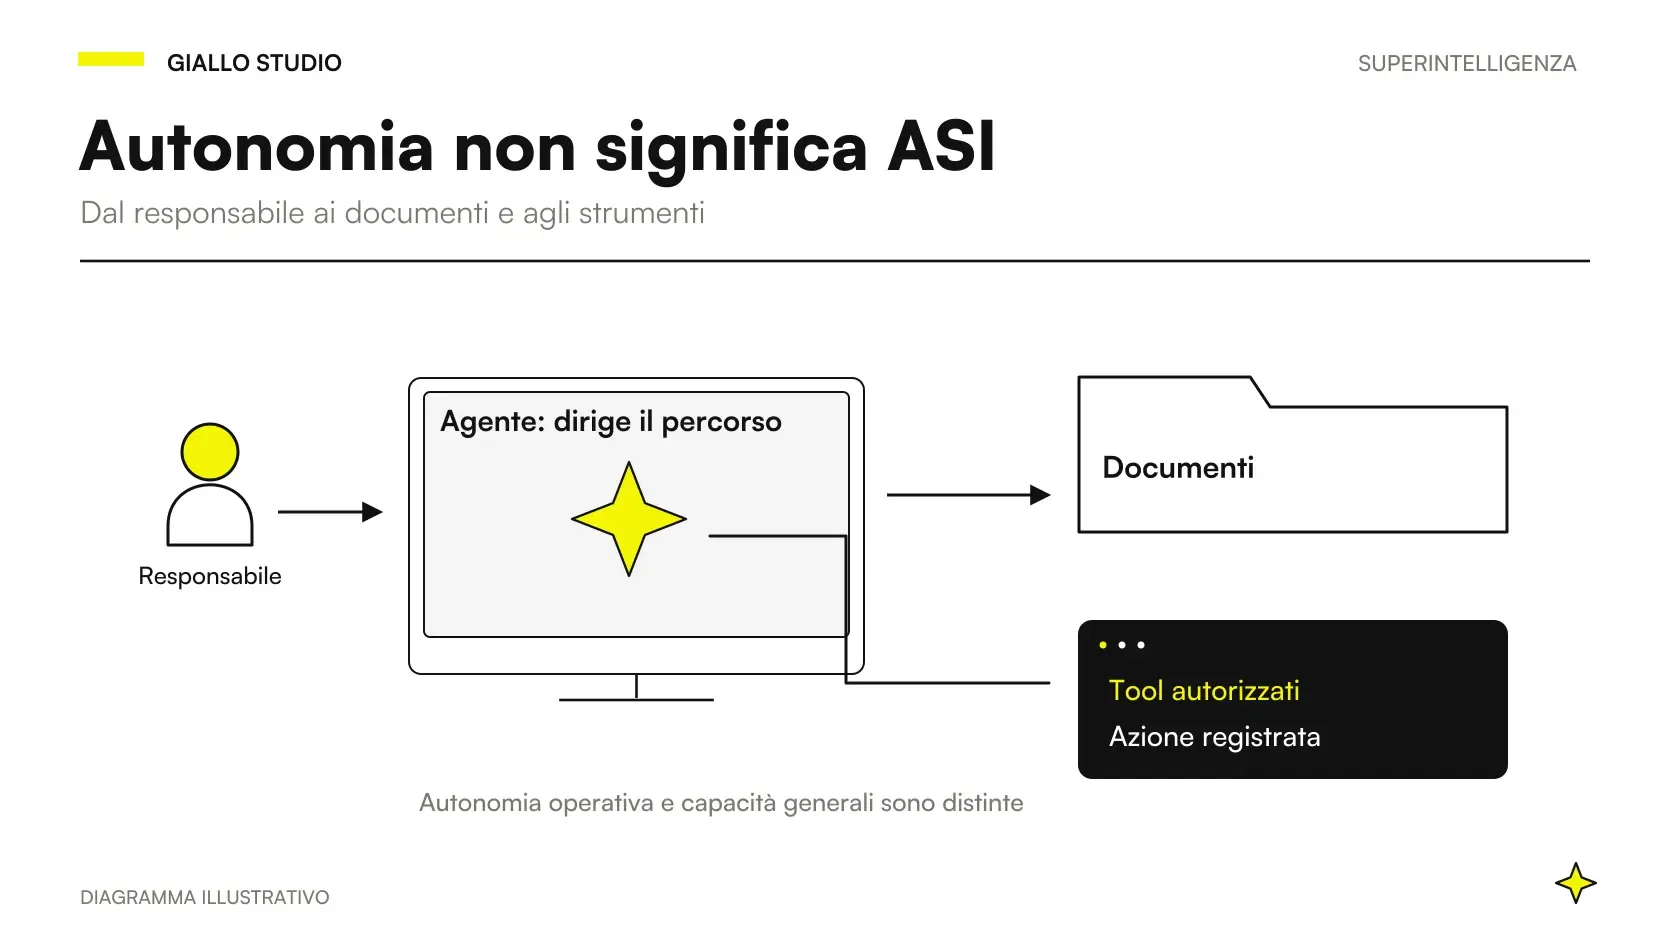
La distinzione tra autonomia e capacità degli agenti torna utile: un sistema capace può avere pochi permessi; un sistema mediocre può avere accesso troppo ampio. Il controllo è una scelta progettuale da motivare, senza trasformarlo in un'etichetta di intelligenza.
Come si vede il problema in un'impresa di impiantistica?
Scenario ipotetico, non cliente Giallo: un'impresa di Verona usa un agente per preparare gli interventi sulla base di richieste e schede tecniche. Il sistema propone materiali e attività, poi chiede al responsabile di approvare una bozza. L'obiettivo è ridurre il lavoro di ricostruzione delle informazioni.
La proposta contiene un riferimento tecnico apparentemente corretto, ma applicabile a una configurazione diversa. Il responsabile vede una lista ordinata e una motivazione sintetica. Se non viene evidenziata la differenza tra configurazioni, può approvare. Il passaggio umano è avvenuto; il controllo sostanziale può essere fallito.
Una progettazione più verificabile presenta la configurazione usata, la fonte e il dato che manca. Il responsabile può allora capire quale elemento deve controllare. Per alcune condizioni il sistema deve limitarsi a preparare il materiale e sospendere la scelta tecnica. Il risultato atteso include quel confine, invece di misurare soltanto quante bozze vengono completate.
Il test potrebbe inserire una scheda vecchia ma plausibile accanto a quella corrente. La domanda non è se l'agente produce una proposta elegante. È se riconosce il conflitto e se il processo di approvazione lo rende visibile. Questo verifica un rischio specifico del lavoro, senza pretendere di risolvere l'allineamento di una superintelligenza.
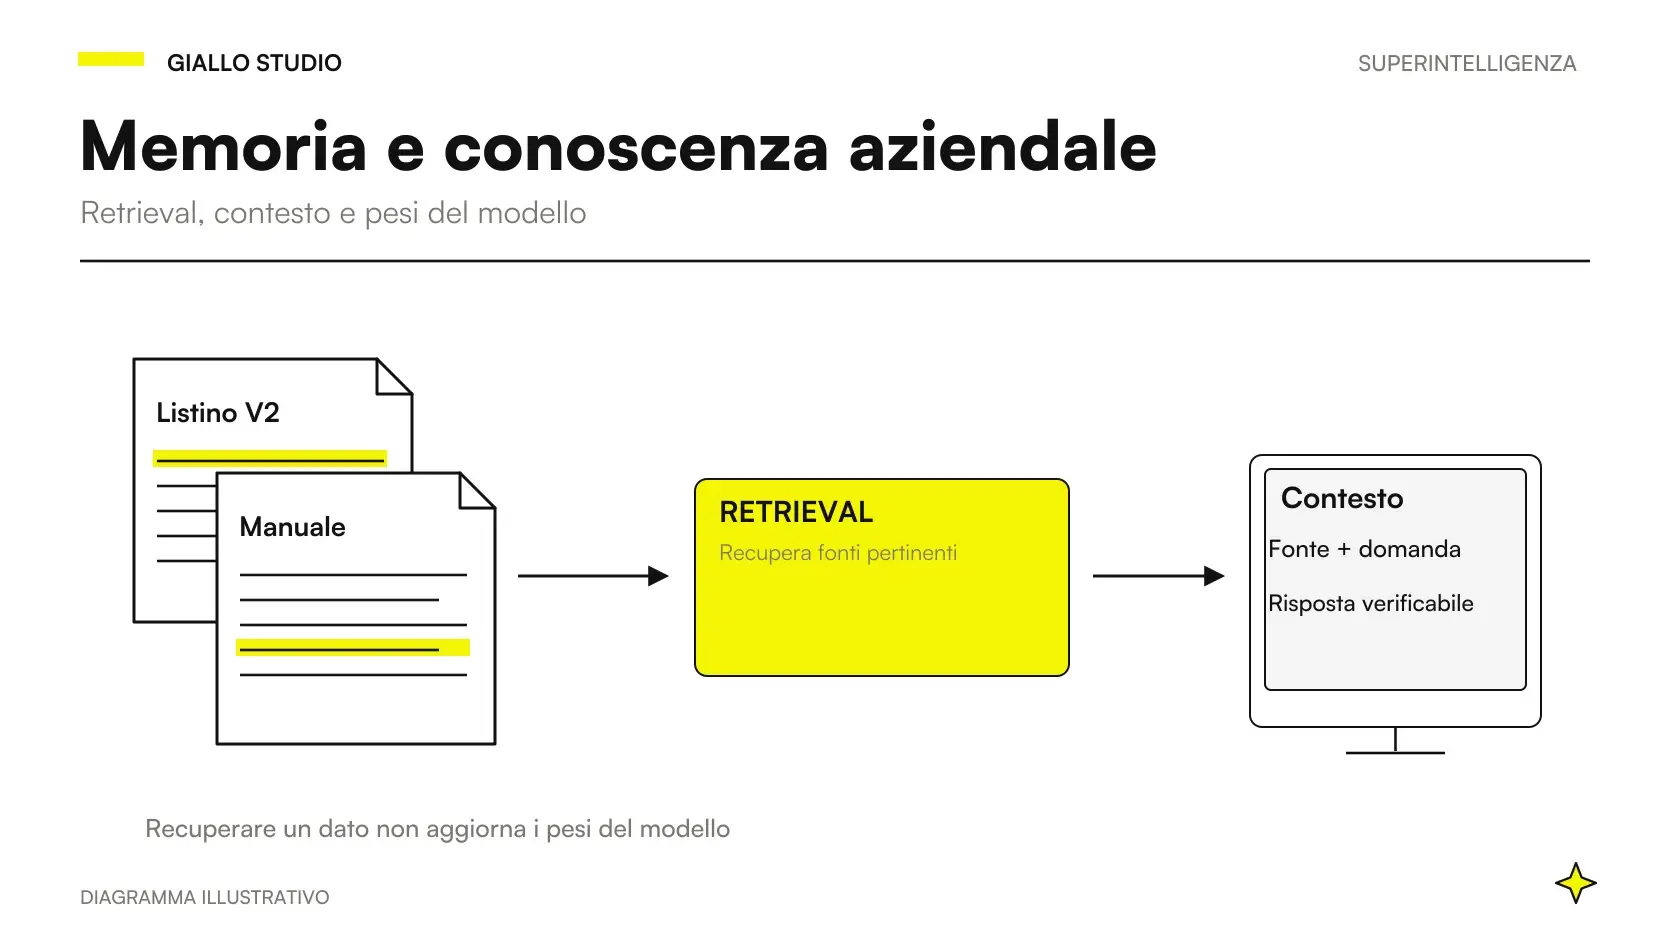
La disponibilità delle fonti è approfondita in memoria e contesto aziendale. Avere il documento corretto nell'archivio aiuta soltanto se entra nel controllo nel momento necessario e mantiene i suoi riferimenti.
Perché una sandbox non è una garanzia completa?
Una sandbox circoscrive un ambiente di esecuzione. Può limitare file, rete o altre risorse secondo la configurazione adottata. È un confine tecnico importante, ma il suo significato va descritto: quali azioni blocca, quali consente e quali servizi sono accessibili attraverso strumenti separati.
Nell'architettura Managed Agents, Anthropic descrive la separazione delle credenziali dal codice eseguito nella sandbox e discute il rischio di prompt injection. È un esempio di protezione di un confine specifico, non una promessa che ogni istruzione malevola o azione scorretta venga neutralizzata. Fonte: Scaling Managed Agents.
Un agente può restare nella sandbox e produrre un documento sbagliato. Può anche usare correttamente uno strumento autorizzato per applicare una decisione errata. Il contenimento dell'esecuzione e la correttezza dell'intento non coincidono. Questa differenza spiega perché servono sia limiti tecnici sia verifiche sul risultato del processo.
Secondo scenario ipotetico: un centro servizi di Bologna prepara fascicoli amministrativi. L'agente lavora su copie dei documenti in un ambiente separato e genera una bozza. La sandbox può evitare che modifichi direttamente l'archivio originale. Non dimostra però che abbia incluso tutti gli allegati necessari o identificato correttamente il richiedente.
Se il sistema dispone anche di uno strumento per pubblicare il fascicolo, dobbiamo esaminare quel percorso separatamente. Il confine del file locale non descrive il permesso sul servizio esterno. Una bozza può essere reversibile; una pubblicazione può avere conseguenze diverse. La prova deve seguire l'azione reale fino al suo esito.
Per leakage, accessi e gestione operativa dei dati rimandiamo alla guida su AI e sicurezza dei dati. Qui interessa il limite concettuale: nessuna singola protezione tecnica dimostra da sola che un sistema persegua sempre gli obiettivi desiderati.
Come mettere alla prova un'approvazione umana?
Un test del controllo può includere un errore noto e chiedere al revisore di valutarlo usando l'interfaccia prevista. Se l'errore non viene visto, bisogna capire perché: informazione nascosta, criterio non chiaro o competenza mancante. Il risultato riguarda il processo di revisione, non una colpa individuale.
Questo esercizio è utile anche quando il modello migliora. Proposte più sofisticate possono richiedere controlli più competenti. Non è sufficiente presumere che il responsabile riconosca ogni problema perché conosce l'azienda. Il dominio del risultato può essere più ampio della sua esperienza o includere una complessità difficile da ricostruire rapidamente.
Apri la prova del verificatore: un difetto noto supera l'approvazione?
Prepara una proposta plausibile con un errore rilevante e già compreso: una fonte superata, un destinatario errato o un vincolo omesso. Mostrala nello stesso formato previsto dal processo, senza aggiungere suggerimenti che nella realtà non comparirebbero.
Osserva quali elementi usa chi verifica e se l'errore viene riconosciuto. Se passa, modifica il modo in cui sono esposte le evidenze o restringi l'azione consentita. Ripetere la conferma senza cambiare il controllo non affronta la causa.
Il test misura un difetto specifico della supervisione. Non dimostra che ogni errore futuro verrà individuato né che il sistema sia allineato in senso generale.
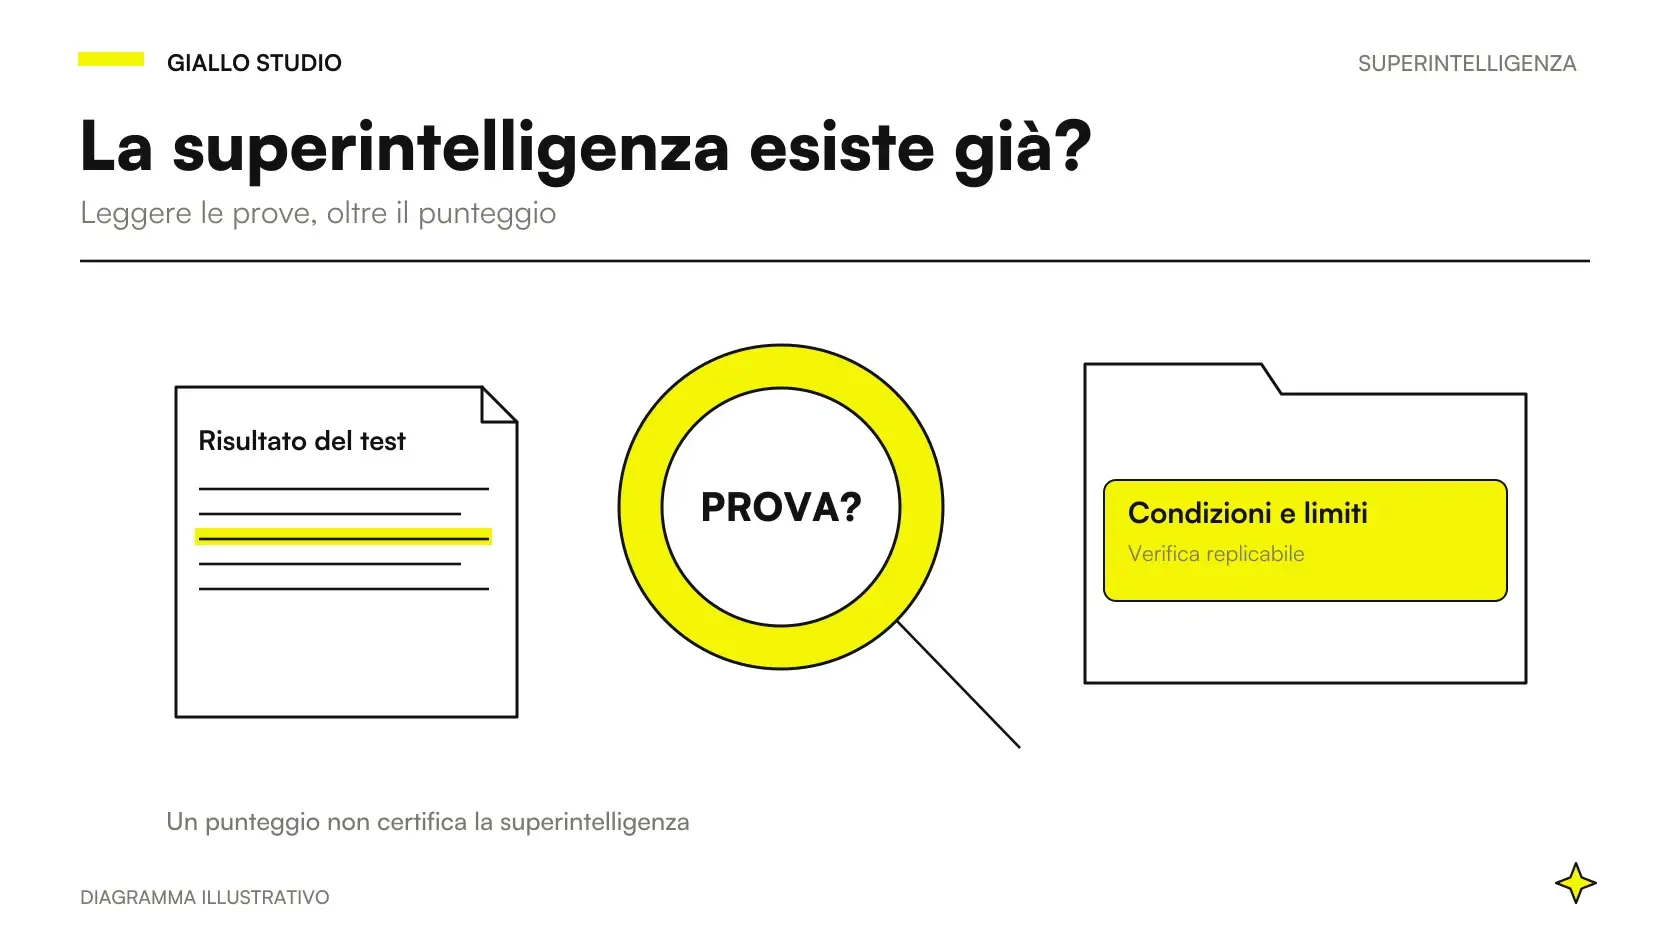
L'assenza di errori osservati non equivale a prova di assenza di errori. Un buon rapporto di verifica dichiara anche ciò che non è stato coperto. La distinzione fra prove disponibili e conclusioni più ampie è trattata nell'articolo su superintelligenza: esiste già?.
Quali errori rendono il controllo solo apparente?
Verificare la frase anziché l'esito. «Operazione completata» può essere una descrizione errata. Quando possibile, il controllo deve leggere lo stato risultante e confrontarlo con il risultato atteso. La verifica del testo da solo copre un'altra proprietà.
Aggiungere approvazioni senza fornire prove. Una conferma può diventare abituale se i casi sembrano sempre ordinari. Fonti, differenze e conseguenze devono essere abbastanza visibili da consentire una valutazione reale. Il disegno del controllo fa parte del sistema.
Chiamare sicuro un componente senza descriverne il confine. Sandbox, permessi e registri hanno funzioni specifiche. Bisogna sapere quale rischio affrontano e quali azioni rimangono possibili. Un nome rassicurante non è un'evidenza.
Usare una prova locale come soluzione generale. Superare un insieme di test giustifica una conclusione limitata a quei comportamenti e condizioni. Le promesse di controllo totale richiederebbero evidenze molto più ampie. La prudenza della conclusione è parte della qualità della valutazione.
Quali criteri di accettazione può definire una PMI?
Per un processo circoscritto possiamo elencare risultato corretto, azioni consentite, errori non accettabili e modalità di sospensione. Poi assegniamo a ogni criterio una verifica praticabile. Se nessuno sa stabilire se un output è corretto, questo è un limite da affrontare prima di concedere più autonomia.
Il sistema di controllo deve includere chi riceve l'eccezione e come riprende il lavoro. Segnalare un problema a una persona che non ha accesso ai documenti può bloccare il caso senza renderlo gestibile. La qualità della supervisione dipende anche dal collegamento fra ruoli, informazioni e responsabilità.
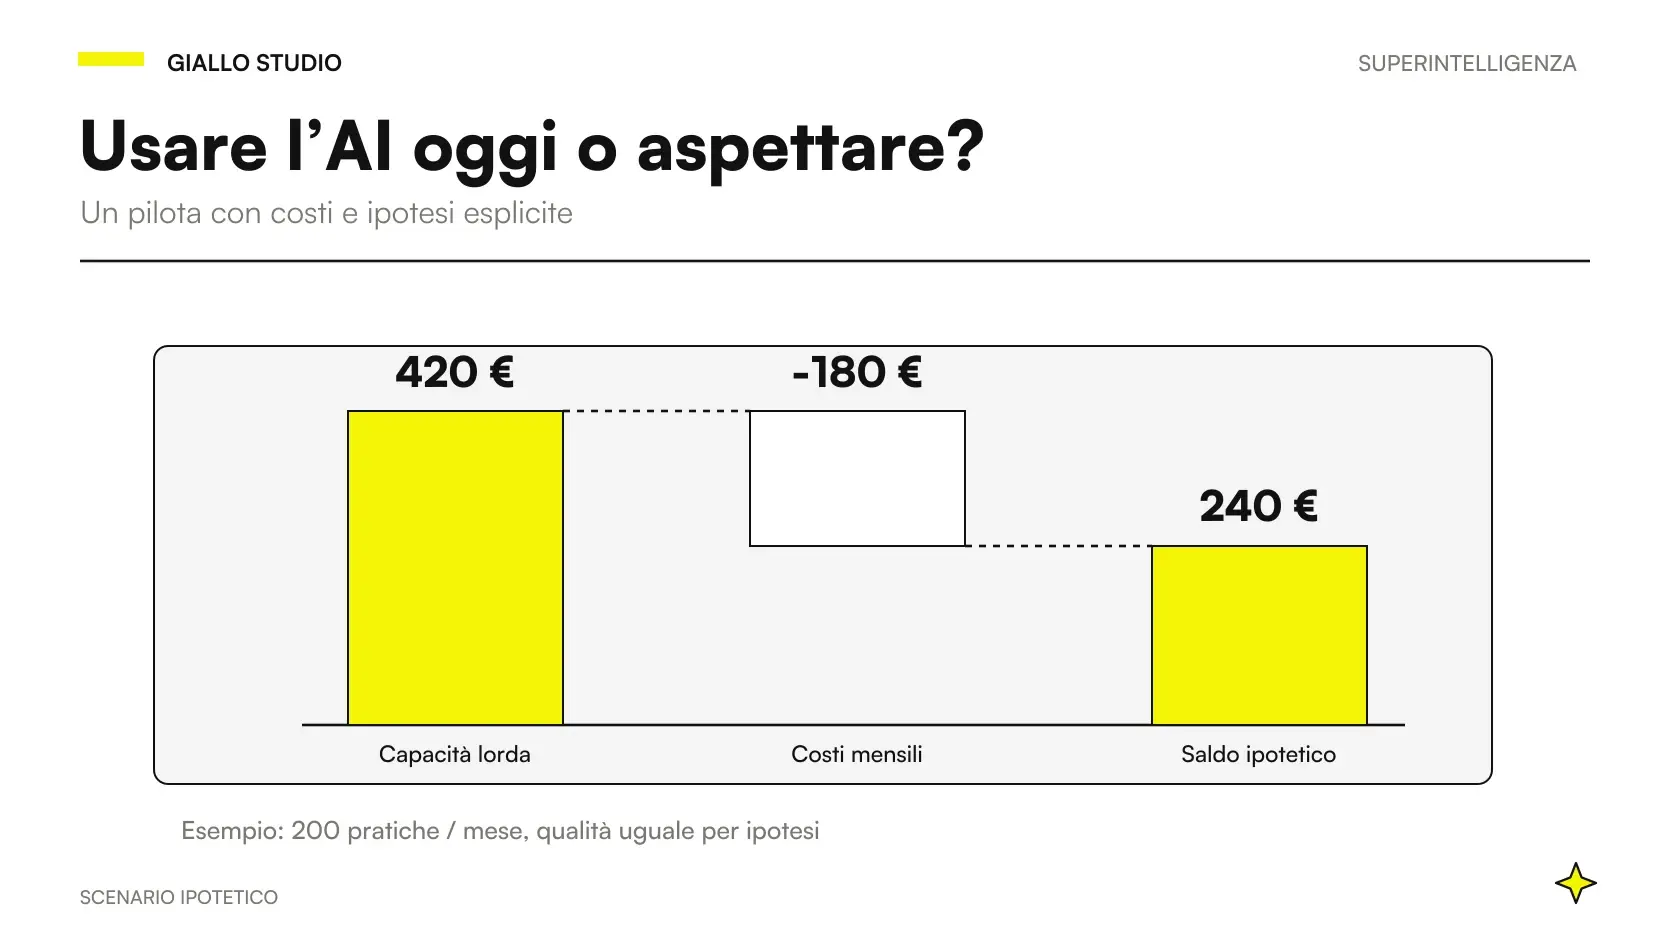
Questi elementi entrano nella scelta se usare l'AI oggi o rinviare il caso. Il punto non è aspettare una promessa di rischio zero, ma disporre di evidenza proporzionata al lavoro che vogliamo delegare.
Possiamo partire dalle azioni e dalle prove, prima di scegliere il grado di autonomia. Il servizio agenti AI di Giallo aiuta a definire il perimetro del processo e i criteri con cui accettare o sospendere un risultato.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
FAQ
Che cosa significa allineamento nella superintelligenza?
Il problema riguarda come ottenere un comportamento coerente con obiettivi e vincoli desiderati anche in sistemi molto capaci. Non coincide con una singola impostazione, una frase nel prompt o una checklist di sicurezza aziendale.
Perché una maggiore capacità può rendere difficile la supervisione?
Un sistema più capace può produrre risultati che una persona fatica a valutare direttamente. Se il verificatore non riconosce un errore, l’approvazione non costituisce una prova di correttezza.
L’approvazione umana garantisce il controllo di un agente?
No, una persona può approvare una proposta incompleta o fuorviante. Il controllo richiede informazioni verificabili, confini d’azione e un processo che consenta di sospendere o correggere il caso.
Una sandbox rende sicuro qualsiasi agente AI?
Una sandbox limita una parte dell’ambiente di esecuzione, ma non garantisce obiettivi corretti o assenza di errori. Contano anche strumenti esterni, credenziali, permessi e azioni effettivamente raggiungibili.
Un secondo modello può certificare il primo?
Un secondo modello può aiutare a individuare problemi, ma può condividere errori o criteri incompleti. Il suo giudizio va verificato su esempi noti e affiancato a controlli indipendenti quando disponibili.
I test degli agenti attuali risolvono l’allineamento ASI?
I test forniscono evidenza su comportamenti e condizioni specifici. Non dimostrano di aver risolto il problema generale di controllare una superintelligenza né garantiscono copertura di ogni situazione futura.