
Perplexity Decider 1.1: smistare ticket con probabilità e soglie controllabili
Perplexity Decider per smistare ticket: output tipizzati, prezzo API corrente e differenza fra confidence e accuratezza. Come preparare un pilota.
Tempo di lettura: 11 min
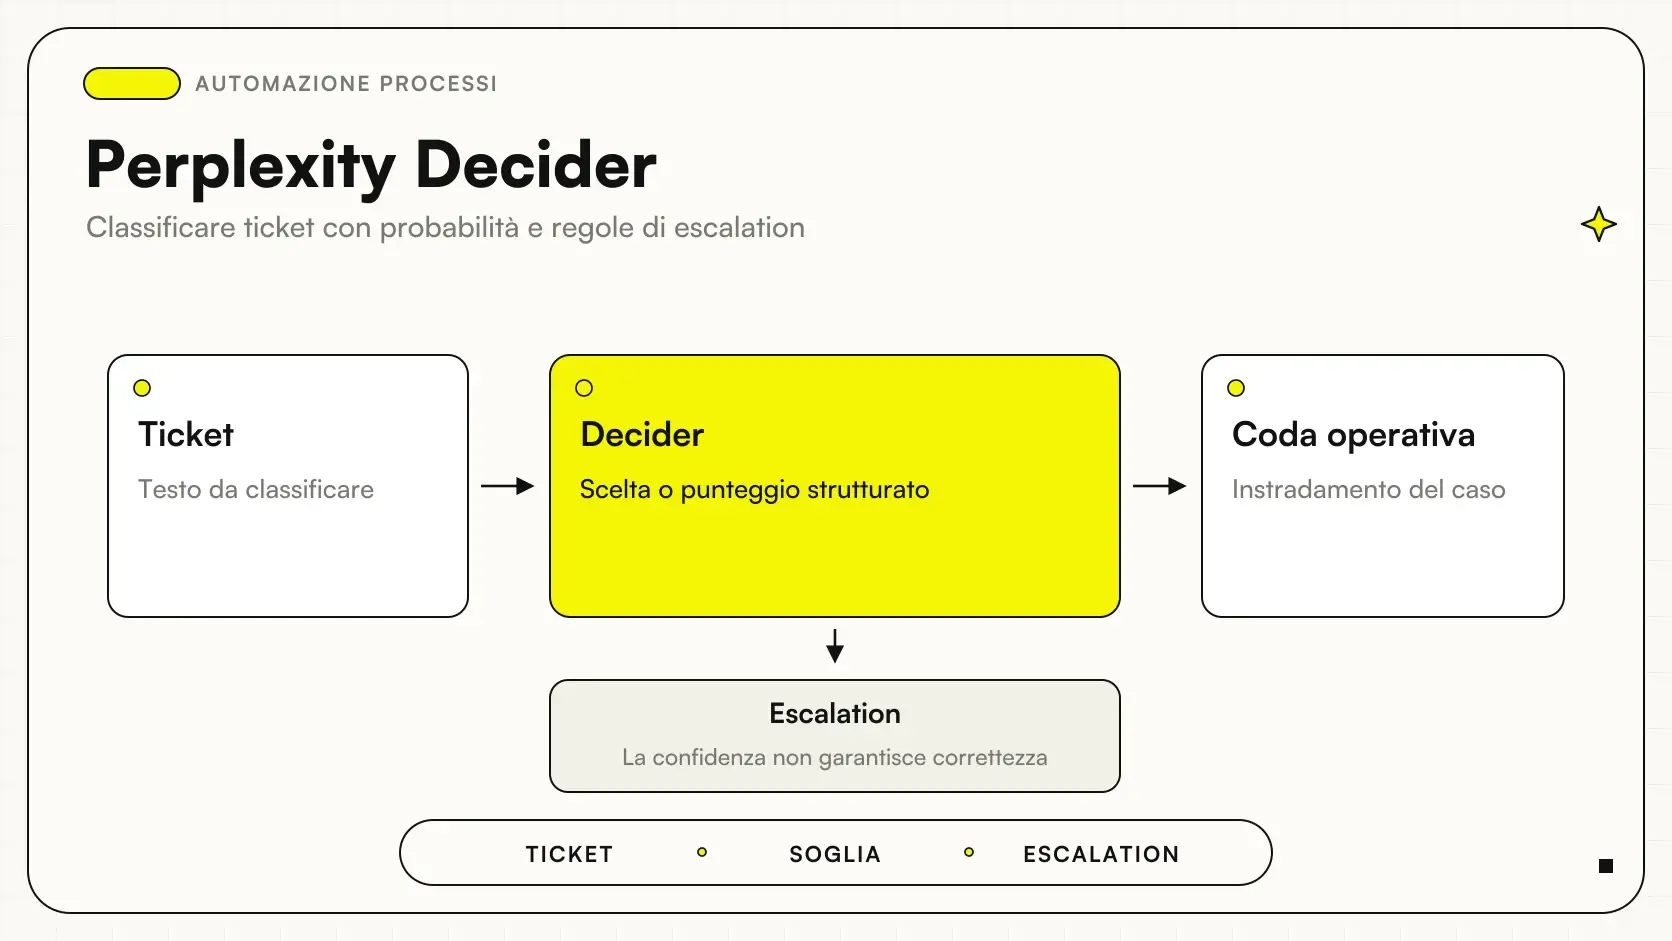
Perplexity Decider è un modello per decisioni tipizzate, come sì/no, scelta fra categorie e punteggio. Nel triage dell'assistenza può aiutare a instradare un ticket verso il percorso appropriato. Non è un chatbot incaricato di scrivere una risposta al cliente e la sua probabilità non equivale alla correttezza della decisione.
L'aggiornamento pplx-decider-v1.1-27b è stato annunciato il 6 ottobre 2026 nel forum ufficiale. Il quickstart corrente indica 0,02 dollari per milione di token di input, output gratuito e nessun costo per richiesta. Il changelog generale conserva riferimenti precedenti: per versione e prezzo bisogna usare le pagine aggiornate, senza mescolare informazioni. Annuncio Perplexity e quickstart Decisions.
Per una PMI, il progetto inizia dalle categorie e dagli errori accettabili. Un ticket urgente classificato come ordinario ha conseguenze diverse da un caso ordinario trasferito a una persona. Prima di automatizzare bisogna rendere esplicita questa differenza e definire un percorso per l'incertezza.
In sintesi
- Decider restituisce decisioni tipizzate, anziché una risposta conversazionale libera.
- Categorie e istruzioni devono descrivere il processo reale dell'azienda.
- La confidence del modello va valutata su esempi propri e non letta come accuratezza garantita.
- Le richieste dubbie devono poter passare a una persona senza essere forzate in una categoria.
- Prezzo API e costo completo del sistema sono due misure differenti.
Perché uno smistamento può richiedere meno di un agente?
Un agente può cercare dati e scegliere strumenti per raggiungere un obiettivo. Uno smistamento a categorie fisse è spesso un compito più ristretto: leggere la richiesta e proporre il percorso. Affidargli l'intera assistenza introduce responsabilità ulteriori, come rispondere, promettere un intervento o aggiornare una pratica.
Decider offre tipi yes/no, choice e score, secondo il quickstart. La forma dell'output aiuta a integrare il risultato in un flusso, ma non elimina gli errori semantici. Una categoria valida può essere quella sbagliata per la richiesta. La verifica deve riguardare il significato della decisione, non soltanto il formato. Comportamento documentato.
La guida agli agenti AI per aziende aiuta a distinguere questi livelli. Per partire, può bastare una proposta di categoria mostrata al personale. Le azioni automatiche arrivano quando l'azienda ha evidenze sul comportamento e regole chiare per ciò che il sistema non deve decidere.
Come definire categorie che non si sovrappongano?
Le categorie devono essere comprensibili a chi valuta i ticket. “Commerciale” e “richiesta informazioni” possono sovrapporsi; “problema tecnico” e “cliente insoddisfatto” descrivono dimensioni differenti. Se gli operatori non concordano sulla categoria corretta, il modello riceve un compito ambiguo prima ancora di essere usato.
Conviene scrivere per ogni categoria ciò che include, ciò che esclude e il percorso successivo. Una richiesta che contiene più temi può richiedere una categoria principale, più etichette oppure revisione. La scelta dipende dal processo. Non va lasciata implicita soltanto perché l'API richiede un valore.
È utile conservare esempi di confine. Una domanda sul prezzo di un ricambio può essere commerciale; una contestazione su un prezzo già fatturato può seguire un'altra procedura. Le istruzioni devono riflettere questa distinzione. Il modello non dovrebbe inventare le responsabilità del reparto né dedurle dalla sola somiglianza delle parole.
Confidence e accuratezza sono la stessa cosa?
No. La confidence è un'informazione prodotta dal modello sul risultato, mentre l'accuratezza si misura confrontando decisioni e riferimenti corretti su un insieme di casi. Un valore elevato non dimostra che quel ticket sia stato classificato bene. Il quickstart richiama questo limite e la necessità di interpretare le probabilità nel contesto. Indicazioni Perplexity. Lo stesso criterio va rivalutato per ogni modello e insieme di richieste: la guida alla confidence di JEV e alla revisione umana collega le soglie a errori osservati e conseguenze operative.
La soglia va scelta in base agli errori osservati e al costo delle conseguenze. Non viene qui proposta una soglia universale: un'assistenza ordinaria e una procedura con richieste critiche possono richiedere regole diverse. Anche due categorie dello stesso processo possono avere rischi asimmetrici.
Serve inoltre osservare i casi incerti, invece di eliminarli dalla valutazione. Sono spesso quelli che mostrano dove le categorie siano poco chiare o le informazioni insufficienti. Un percorso di revisione non è un fallimento del sistema: è una parte prevista del servizio quando la decisione automatica non ha evidenze sufficienti.
Quali esiti dovrebbe gestire il flusso?
| Esito della valutazione | Azione possibile | Controllo necessario |
|---|---|---|
| Categoria chiara e autorizzata | Instradamento previsto | Regole e dati minimi |
| Categoria dubbia | Revisione del personale | Contesto e motivo leggibili |
| Informazioni mancanti | Richiesta di chiarimento | Nessuna inferenza arbitraria |
| Richiesta fuori perimetro | Percorso generale di assistenza | Destinazione definita |
| Errore API | Procedura alternativa | Nessun ticket perso |
La tabella descrive un disegno applicativo proposto, non funzioni che l'API configura automaticamente. Il sistema esterno deve registrare lo stato della richiesta e sapere quando una decisione è disponibile. Un timeout non deve far sparire il ticket né generare più lavorazioni indipendenti della stessa richiesta.
Le OpenAI Decisions API affrontano un intento simile con caratteristiche proprie. Il confronto utile riguarda tipi di output, condizioni, qualità sui casi aziendali e integrazione. Non viene dichiarato un vincitore sulla base del prezzo o di benchmark del fornitore, perché il comportamento sul processo italiano richiede prove specifiche.
Scenario ipotetico: un distributore smista l'assistenza
Immaginiamo un distributore che riceve richieste su consegne, resi e informazioni tecniche. Decider propone il percorso, mentre regole ordinarie verificano identificativo della pratica e dati obbligatori. Un operatore controlla i casi dubbi e quelli che possono comportare impegni commerciali.
Il team prepara ticket di prova con formulazioni diverse, compresi messaggi che contengono più problemi. Le risposte corrette sono definite dagli operatori prima del test. Se alcuni esempi non hanno un esito condiviso, si chiarisce la procedura invece di attribuire subito il disaccordo al modello.
Questo è uno scenario ipotetico. La misura utile è la correttezza per categoria e la gestione dei casi che richiedono una persona. Non vengono promessi risparmi o tempi di risposta. Il pilota deve verificare anche l'integrazione: la categoria corretta deve arrivare alla pratica giusta e il personale deve poter correggerla senza perdere il contesto.
Scenario ipotetico: una società di servizi instrada i contatti
Consideriamo una società che riceve dal sito richieste di preventivo, candidature e domande da clienti esistenti. Il classificatore propone un percorso, ma non invia automaticamente un'offerta né decide il valore commerciale del contatto. Una regola separata gestisce i dati mancanti e una persona valuta i messaggi fuori perimetro.
Il team include nei test richieste brevi, testi copiati, allegati citati ma assenti e messaggi che cambiano argomento. Un testo che contiene parole come “preventivo” non deve essere classificato meccanicamente come nuova opportunità se in realtà contesta un documento precedente. Gli esempi devono rappresentare queste differenze.
Anche questo caso è ipotetico. La proposta può essere inserita in un flusso come quello di Zapier Agents e AI by Zapier, verificando però il collegamento effettivamente disponibile. Non viene qui affermata un'integrazione pronta: il punto è separare classificazione, regole e azioni esterne.
Come preparare una valutazione prima dello smistamento automatico?
Apri la scheda per un test del classificatore
Definisci categorie, esclusioni ed esiti corretti con il personale. Prepara richieste rappresentative e casi di confine, senza dati personali non necessari. Conserva un insieme separato per la verifica. Misura gli errori per categoria, osserva confidence e casi dubbi, poi scegli soglie e percorso umano in base alle conseguenze.
È importante distinguere falsi instradamenti e revisioni eccessive. Un sistema può ridurre un tipo di errore mandando quasi tutto al personale, ma questo cambia il valore operativo. La valutazione deve rendere visibile il compromesso, senza cercare un numero unico che nasconda categorie e conseguenze.
Anche la composizione del test conta. Se contiene soprattutto richieste semplici, può suggerire una qualità che non si ritrova nella coda reale. Servono esempi pertinenti ai canali e al linguaggio dell'azienda. Le correzioni degli operatori possono alimentare una revisione successiva, mantenendo separati i casi già usati per mettere a punto le istruzioni.
Come leggere il prezzo API senza fermarsi al numero?
Il quickstart corrente riporta 0,02 dollari per milione di token di input, output gratuito e nessun costo per richiesta. La pagina aggiornata va preferita al changelog generale che conserva il precedente riferimento a 0,04 dollari e alla versione iniziale. È una discrepanza documentale da riconoscere, non una tariffa da combinare liberamente. Prezzo nel quickstart.
Il costo complessivo comprende integrazione, valutazione, log, revisione e manutenzione. Anche un prezzo basso per token non rende automaticamente sostenibile un sistema che classifica male o richiede molte correzioni. La guida ai token AI aiuta a capire l'unità tecnica, distinta dal costo della pratica gestita.
Non vengono qui calcolate fatture esemplificative o stime di volume. Prima dell'adozione bisogna verificare listino corrente, disponibilità dell'account e condizioni applicabili. Il budget dovrebbe considerare anche il percorso alternativo quando il servizio non risponde, perché la richiesta del cliente resta da gestire.
I pesi aperti rendono semplice il self hosting?
La model card indica licenza Apache 2.0 e richiede accesso Hugging Face autenticato. Riporta circa 49 GiB per i soli pesi: è un riferimento sul materiale del modello, non una stima completa delle risorse di esecuzione. Memoria, runtime e infrastruttura vanno dimensionati separatamente. Model card ufficiale.
Il self hosting può essere valutato quando esistono requisiti e competenze che lo giustificano. Comporta distribuzione, aggiornamenti, monitoraggio e protezione del servizio. La licenza dei pesi non risolve diritti sui dati, accessi del personale o correttezza delle decisioni.
Per una PMI, l'API può essere un percorso iniziale da confrontare con l'assetto interno, senza assumere che uno dei due sia sempre migliore. Il confronto deve includere controllo dei dati, manutenzione e qualità osservata. Una scelta infrastrutturale ha senso se sostiene il processo, non soltanto perché il modello è scaricabile.
Come usare la classificazione in un canale vocale?
Uno smistamento può precedere o accompagnare una conversazione, ma il canale vocale introduce ambiguità aggiuntive. Una trascrizione può perdere nomi o negazioni; il cliente può correggersi. Prima di classificare bisogna capire quale versione della richiesta sia stata confermata e quali informazioni manchino.
Amazon Nova Sonic riguarda il dialogo vocale e l'uso degli strumenti. Decider riguarda una decisione tipizzata. I ruoli possono essere progettati nello stesso sistema, ma il collegamento richiede test propri. Non basta trasferire la soglia di un insieme di email a telefonate con contenuti differenti.
La guida all'automazione con Zapier mostra come una decisione possa entrare in un percorso operativo. In qualunque piattaforma, la categoria deve essere un dato controllato. Non dovrebbe diventare un'autorizzazione implicita a inviare messaggi, applicare sconti o modificare condizioni senza altre regole.
Quali errori evitare con probabilità e soglie?
Il primo è trattare confidence e accuratezza come sinonimi. Il secondo è scegliere una soglia perché sembra alta, senza valutare gli errori. Il terzo è forzare ogni richiesta in una categoria. Il quarto è misurare soltanto il risultato medio, nascondendo il comportamento sulle richieste più delicate.
Un altro errore è ignorare il cambiamento del processo. Nuovi prodotti, categorie o canali possono modificare il linguaggio dei ticket. Il classificatore deve essere rivisto quando cambia il lavoro. Le correzioni del personale devono essere raccolte con un metodo che permetta di distinguere errore del modello e regola aziendale modificata.
Infine, non bisogna lasciare senza proprietario i casi dubbi. Una coda di revisione è utile soltanto se qualcuno la controlla e sa come intervenire. Il sistema deve conservare lo stato e rendere visibile ciò che resta incompleto. Una probabilità ben formattata non sostituisce questa responsabilità.
Come raccogliere le correzioni senza perdere il motivo?
Quando un operatore cambia categoria, il sistema dovrebbe conservare il motivo essenziale. La decisione iniziale poteva essere sbagliata, oppure il ticket poteva contenere informazioni insufficienti. Sono situazioni diverse e richiedono interventi diversi: migliorare le istruzioni, cambiare il modulo o prevedere una richiesta di chiarimento.
Un registro proporzionato può collegare categoria proposta, esito corretto e tipo di problema. Non serve copiare ogni contenuto nella traccia di valutazione. Il team deve poter analizzare gli errori mantenendo il controllo dei dati e sapendo chi può consultare gli esempi.
Questa revisione dovrebbe coinvolgere chi conosce il processo. Un tecnico può verificare formato e chiamate API, ma potrebbe non sapere perché una contestazione segua un percorso particolare. La qualità della classificazione dipende anche da questa conoscenza operativa. Renderla esplicita permette di correggere il sistema senza affidarsi a eccezioni nascoste nella memoria degli operatori.
Da quale coda conviene partire?
Scegli una coda con categorie comprensibili e personale disponibile a definire gli esiti corretti. Inizia con proposte visibili agli operatori, osserva gli errori e decidi quali passaggi possano diventare automatici. Mantieni un percorso chiaro per richieste ambigue, dati mancanti e guasti del servizio.
Se vuoi smistare assistenza o contatti senza affidare al modello l'intero rapporto con il cliente, Giallo può progettare automazioni aziendali con categorie e revisione. Il risultato da chiedere è una decisione utile nel processo, con soglie motivate da prove e una persona pronta a intervenire quando serve.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 OpenAI Decisions API in beta: classificare ticket e richieste con risposte controllabili
 Zapier Agents diventa AI by Zapier: migrazione, approvazioni e fonti ancora mancanti
 Amazon Nova 2.5 Sonic: agenti vocali in italiano con strumenti e controllo umano
 Agenti AI per aziende: quando servono davvero e come si adottano
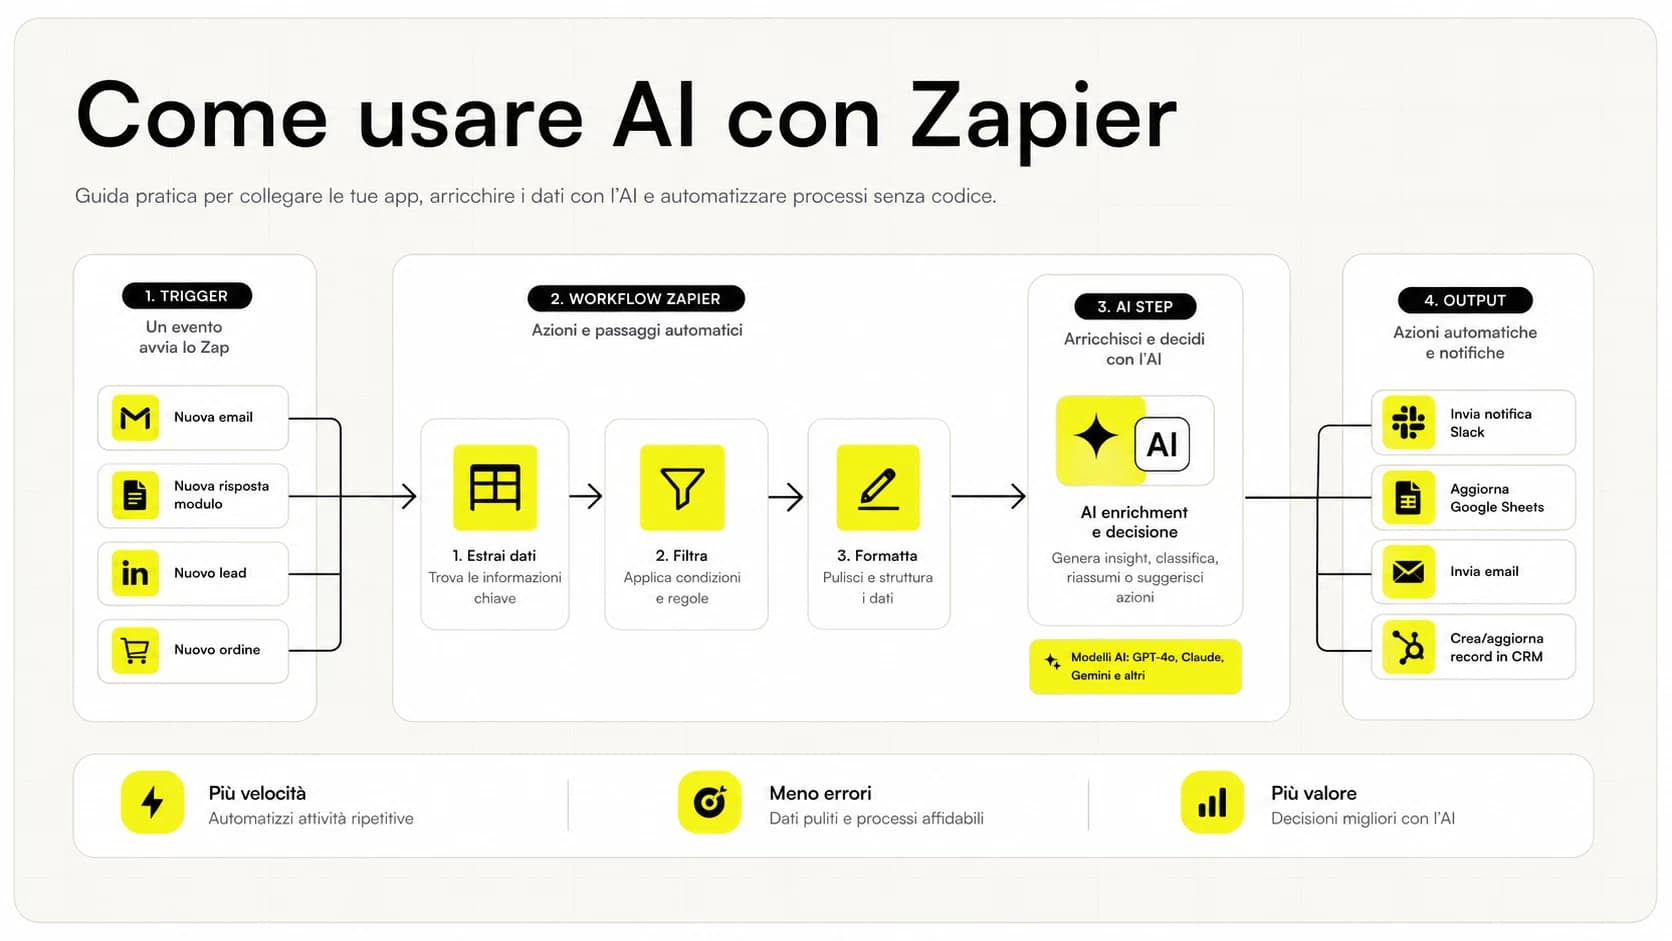 Zapier: cos'è e come funziona, guida pratica per PMI
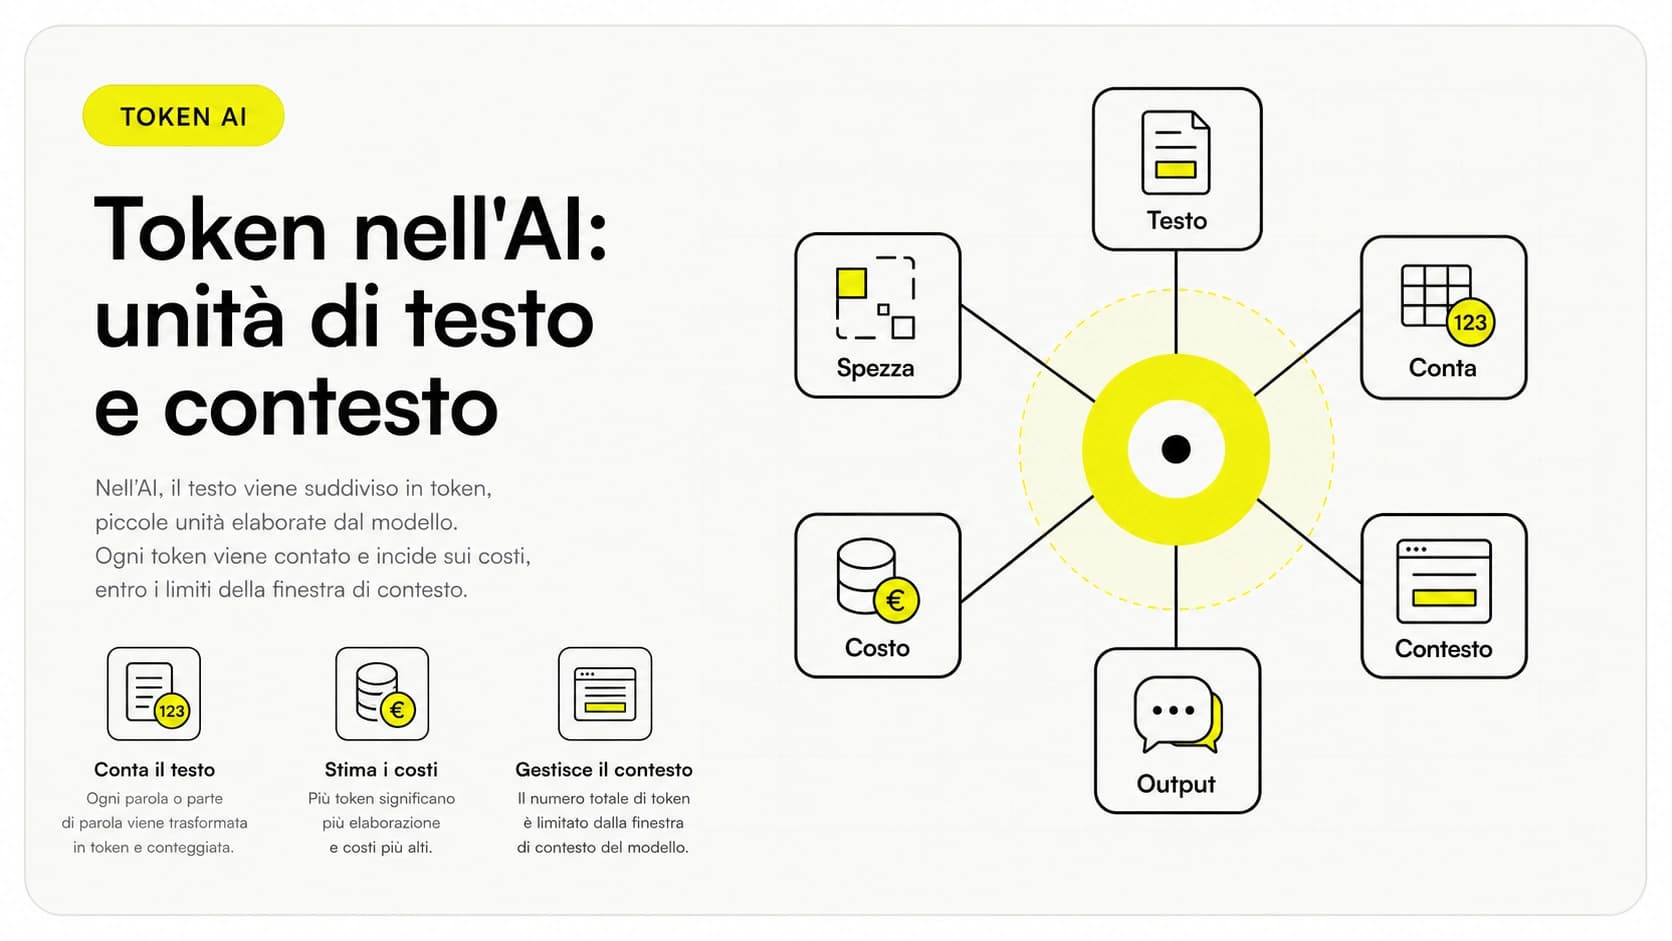 Cosa sono i token AI: come si contano e quanto costano (ottobre 2026)
FAQ
Che cos'è Perplexity Decider?
È un modello per decisioni tipizzate come sì/no, scelta e punteggio. Non è un chatbot incaricato di scrivere risposte conversazionali ai clienti.
La confidence dimostra la correttezza?
No, la probabilità prodotta dal modello non equivale all'accuratezza osservata. Servono esempi propri, esiti corretti e soglie motivate dal rischio.
Qual è il riferimento aggiornato per il prezzo?
Il quickstart corrente delle Decisions API, da verificare prima dell'adozione. Il changelog generale conserva riferimenti precedenti e non va mescolato con le condizioni aggiornate.
I casi dubbi devono avere comunque una categoria?
Non necessariamente: il flusso può prevedere revisione o richiesta di chiarimento. Forzare una scelta può peggiorare il processo quando manca informazione.
I pesi aperti rendono semplice il self hosting?
La disponibilità dei pesi non dimensiona l'infrastruttura. Runtime, memoria, aggiornamenti e gestione del servizio richiedono una valutazione separata.
Da dove partire con lo smistamento?
Da categorie chiare e proposte visibili agli operatori. Dopo la valutazione si decide quali passaggi automatizzare, mantenendo un percorso per casi dubbi ed errori API.