
OpenAI Decisions API in beta: classificare ticket e richieste con risposte controllabili
OpenAI Decisions API entra in beta pubblica. Come usare categorie, probabilità e revisione umana per smistare ticket senza affidarsi al testo libero.
Tempo di lettura: 11 min
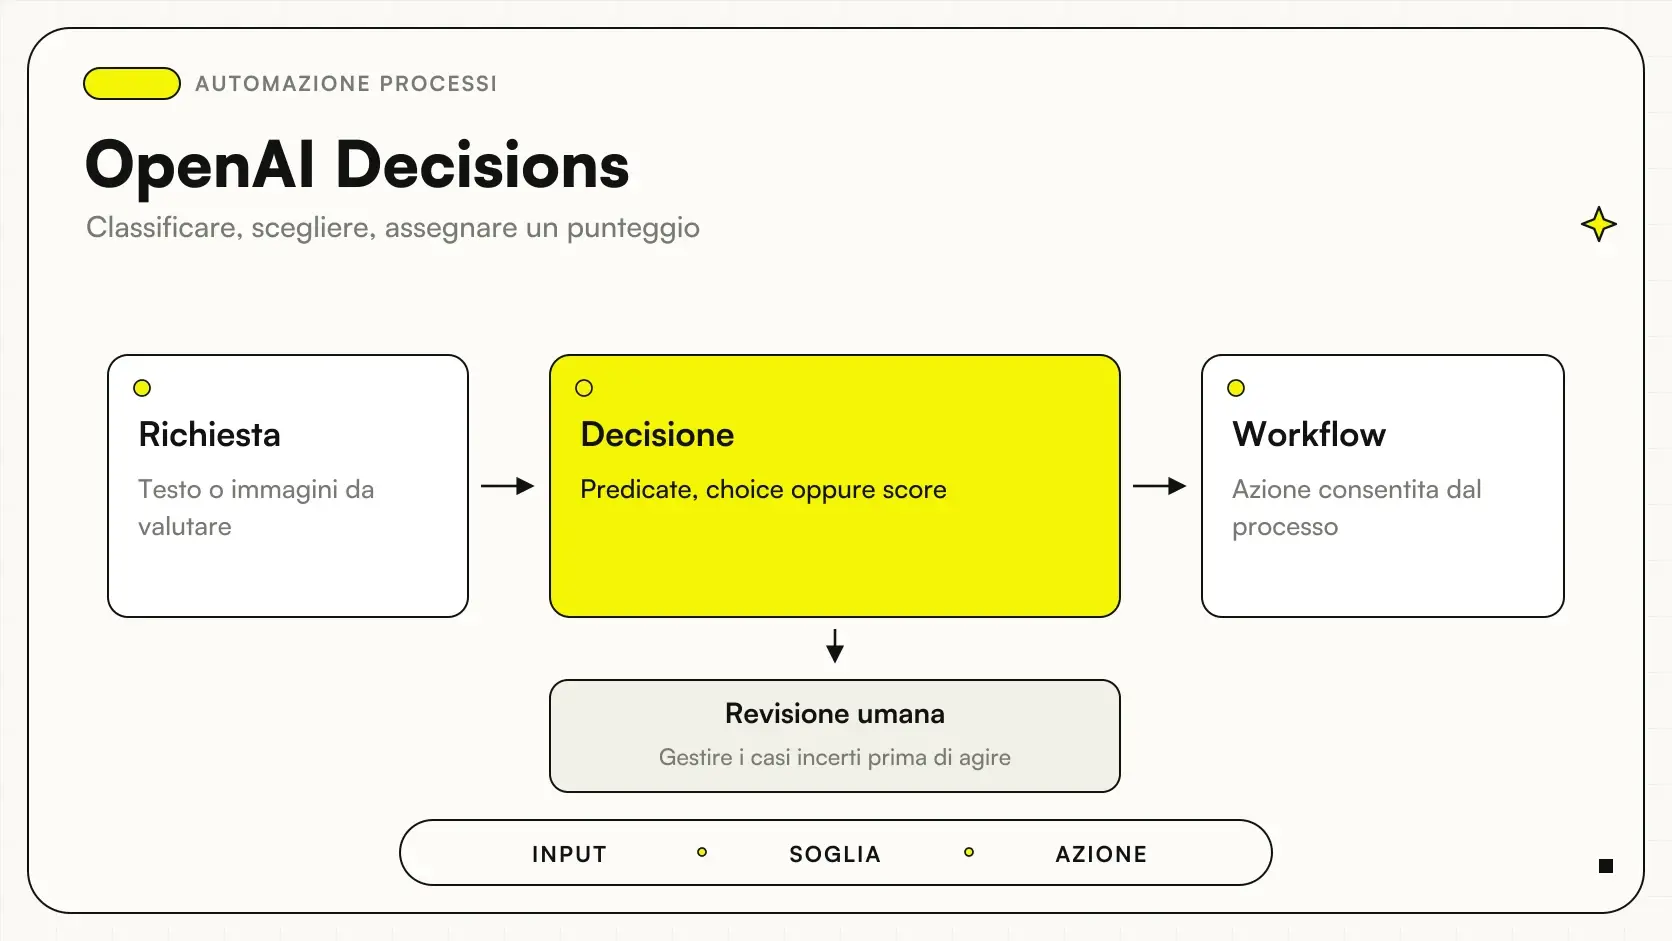
OpenAI Decisions API serve a ottenere una decisione in un formato definito, invece di una risposta libera da interpretare. La beta pubblica è disponibile dal 6 ottobre 2026, come riportato nel changelog OpenAI. È una data distinta dall’annuncio iniziale: la notizia riguarda l’apertura dell’accesso pubblico alla beta, non il debutto dell’idea.
Per una PMI il caso più immediato è lo smistamento delle richieste: assistenza tecnica, informazioni commerciali, amministrazione o passaggio a un operatore. La differenza pratica rispetto a una chat è il contratto della risposta. Il sistema riceve un valore previsto dall’integrazione, ma questo valore deve comunque essere corretto. Formato controllato e decisione affidabile sono due requisiti separati.
In sintesi
- Decisions API è pensata per decisioni strutturate su input, non per una conversazione generica.
- Categorie e criteri vanno definiti prima della richiesta al modello.
- Una probabilità dichiarata non equivale alla correttezza sul proprio archivio.
- I casi incerti devono avere una destinazione operativa esplicita.
- La classificazione non autorizza da sola rimborsi, chiusure o modifiche al CRM.
Che cosa restituisce l’endpoint Decisions?
La guida ufficiale descrive l’endpoint /v1/decisions e, al lancio, il modello gpt-6-luna. Gli ingressi possono essere testo e immagini; i tipi di decisione previsti sono predicate, choice e score. Versioni e modelli supportati vanno verificati nella stessa documentazione prima di sviluppare un’integrazione. Questi dettagli non implicano che ogni archivio di ticket sia già pronto per essere elaborato. La scelta dipende anche da che cosa deve produrre il sistema: il confronto fra JEV e LLM generativi separa un esito tipizzato da una risposta scritta per il cliente.
Un predicate risponde a una condizione definita, per esempio se una richiesta contiene un numero d’ordine leggibile. Una choice seleziona fra alternative preparate dall’azienda, come reparto commerciale o assistenza. Uno score esprime una valutazione secondo il criterio impostato. Il criterio non deve restare implicito: parole come urgente, importante o interessante assumono significati diversi fra reparti e producono etichette incoerenti se non vengono spiegate.
| Forma della decisione | Domanda aziendale adatta | Controllo necessario |
|---|---|---|
| Predicate | È presente l’informazione richiesta? | Definire cosa conta come presenza valida |
| Choice | A quale categoria appartiene il ticket? | Alternative distinguibili e gestione dell’ambiguità |
| Score | Quanto rispetta un criterio dichiarato? | Scala e casi di riferimento condivisi |
| Azione successiva | Quale procedura avviare? | Permessi e condizioni separati dalla decisione |
La differenza fra endpoint e processo completo è centrale anche nella guida alle API AI. Un valore ben formato rende più semplice il collegamento ai sistemi; non stabilisce da solo chi possa agire e con quali conseguenze.
Come costruire categorie che gli operatori riconoscono?
Partire dall’elenco dei reparti spesso non basta. Una richiesta può contenere una domanda commerciale e un problema tecnico, oppure parlare di una fattura senza richiedere una correzione amministrativa. Il team deve decidere se classificare il tema dominante, la prima azione necessaria o tutte le intenzioni presenti. Questa scelta cambia la risposta attesa e va presa prima di confrontare modello e operatori.
Per ogni categoria si prepara una scheda breve: definizione, esempi inclusi, esempi esclusi e destinazione. La categoria assistenza, per esempio, può includere un guasto su prodotto già acquistato ed escludere una domanda sulle caratteristiche prima dell’acquisto. Servono anche esempi di confine. Se due operatori esperti assegnano etichette diverse allo stesso messaggio, la priorità è chiarire la regola, non chiedere al modello più sicurezza.
Una categoria residuale deve essere utile. Altro può diventare una discarica invisibile; da verificare indica invece che un operatore deve leggere la richiesta. Il registro conserva l’etichetta proposta, quella finale e il motivo della modifica. Nel tempo questa differenza segnala nuove categorie, cambiamenti dei prodotti o criteri che non riflettono più il lavoro reale dell’azienda.
Perché la probabilità va calibrata sui propri ticket?
Una probabilità è un segnale da valutare, non un certificato. Il rapporto fra fiducia dichiarata e correttezza può cambiare con abbreviazioni, linguaggio dei clienti, qualità delle immagini e nuove linee di prodotto. L’azienda deve osservare se i casi dichiarati più sicuri risultano effettivamente più affidabili nel proprio campione. Senza questa verifica, una soglia scelta perché sembra prudente rimane arbitraria.
Il campione va separato fra esempi usati per definire le istruzioni ed esempi tenuti da parte per la valutazione. Deve contenere richieste frequenti e casi costosi da sbagliare. Una media complessiva può nascondere un problema: molte informazioni commerciali classificate bene possono compensare rimborsi o reclami gestiti male. Il risultato va quindi letto per categoria, mettendo in evidenza le confusioni fra classi con conseguenze diverse.
In un esempio ipotetico si potrebbe automatizzare soltanto una categoria a basso rischio dopo una verifica soddisfacente e mantenere tutte le altre in revisione. Non esiste una soglia universale adatta a qualsiasi PMI. Il responsabile decide quale errore sia accettabile, quanto costa correggerlo e quando l’operatore debba intervenire prima che il cliente percepisca una conseguenza.
Dove finisce la classificazione e inizia l’automazione?
Un ticket etichettato come reso non dovrebbe produrre automaticamente un rimborso. Per autorizzare il pagamento possono servire ordine valido, condizioni commerciali, stato della merce e un ruolo abilitato. Il valore restituito da Decisions può avviare una verifica, ma l’azione va protetta da regole applicative indipendenti. Questa separazione rende possibile correggere il modello senza riscrivere l’intero processo amministrativo.
L’integrazione dovrebbe conservare un identificativo della richiesta e registrare lo stato del passaggio successivo. Se il CRM è momentaneamente indisponibile, un nuovo tentativo non deve creare due attività uguali. Se l’etichetta viene rettificata, l’operatore deve vedere chi ha ricevuto la pratica e se qualcosa è già stato eseguito. È un problema di automazione del CRM, non soltanto di qualità linguistica.
Quando il flusso diventa più articolato, la distinzione fra classificatore e agente AI aziendale aiuta a scegliere l’architettura. Un compito con alternative fisse può richiedere una integrazione semplice. Aggiungere autonomia e strumenti ha senso soltanto se il processo richiede davvero ricerca, pianificazione o interazione con altri sistemi.
Un e-commerce può separare consegne, resi e richieste commerciali?
Scenario ipotetico. Un piccolo e-commerce italiano vuole ordinare la coda di assistenza. Le categorie iniziali sono stato consegna, reso, informazione prima dell’acquisto e richiesta da verificare. L’input include il messaggio e, quando necessario, una fotografia allegata. Il primo pilota propone soltanto una destinazione: l’operatore mantiene la risposta al cliente e può correggere l’etichetta prima di aprire la pratica.
La valutazione deve includere messaggi come “non è arrivato, voglio annullare” oppure “il prodotto è arrivato ma manca un pezzo”. Entrambi parlano di consegna, ma la prima azione può essere diversa. L’azienda prepara una regola sul significato operativo della categoria e controlla se la proposta aiuti davvero a ridurre i passaggi fra reparti. Il numero di riassegnazioni è più utile della semplice presenza di una etichetta.
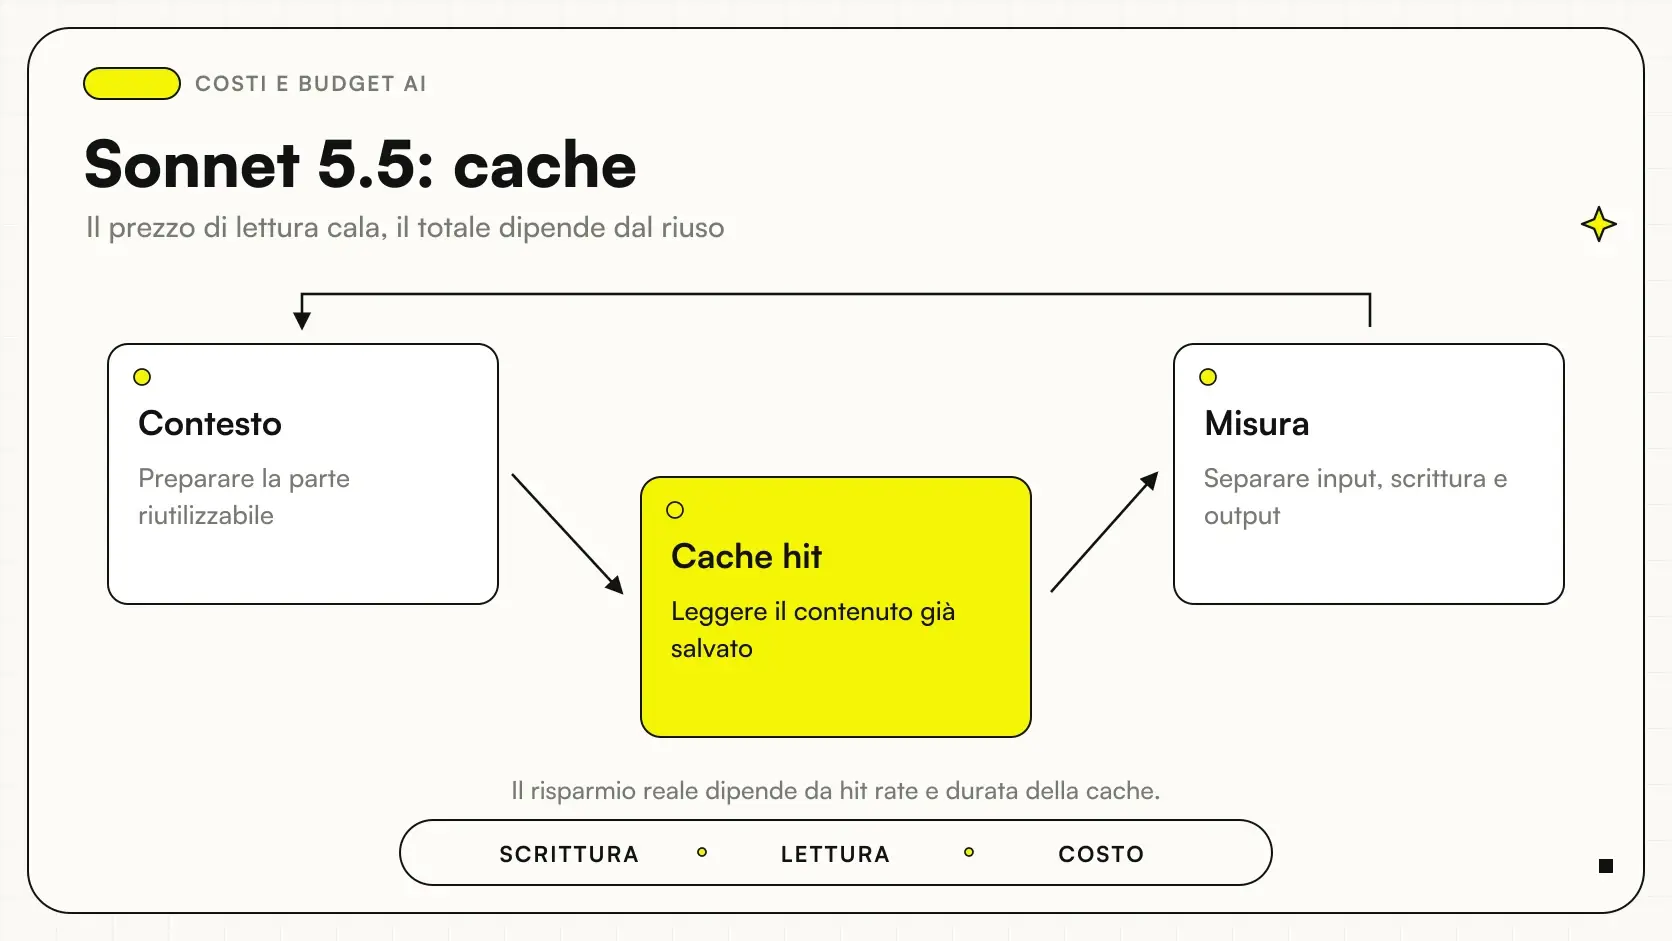
Per leggere il costo servono anche token in ingresso, allegati elaborati e tentativi ripetuti. Il prezzo del modello non coincide con il costo della pratica completata. Il confronto con il prompt caching Sonnet ricorda che ogni endpoint ha una struttura di costo propria: non bisogna trasferire sconti o meccanismi di un servizio a un altro. Tempo di controllo e integrazioni restano voci separate nel bilancio del pilota.
Una società di manutenzione può riconoscere le priorità operative?
Secondo scenario ipotetico. Una PMI che manutiene impianti riceve richieste da edifici e negozi. Il classificatore può distinguere una segnalazione ordinaria da un messaggio che richiede lettura immediata da parte di un responsabile. Non decide autonomamente se un impianto sia sicuro né sostituisce una valutazione tecnica. La categoria serve a far emergere il caso e a indirizzarlo alla persona competente.
Nel campione entrano descrizioni vaghe, fotografie incomplete e messaggi con parole allarmanti usate in modo colloquiale. I falsi negativi meritano un’analisi specifica: una richiesta importante classificata come ordinaria può restare in coda. Il progetto può quindi prevedere regole conservative indipendenti dal modello e una revisione per input non interpretabili. L’obiettivo è supportare la lettura, non promettere una diagnosi automatica.
L’operatore deve poter capire quale criterio abbia prodotto la priorità proposta, senza ricostruire tutta la conversazione tecnica con il modello. Una scheda con testo originale, categoria e motivo della rettifica rende verificabile il processo. I risultati del pilota vanno discussi con chi gestisce le chiamate e con chi esegue gli interventi: la priorità amministrativa e quella tecnica non coincidono sempre.
Quanto costa e quali condizioni verificare in Italia?
La guida indica 0,10 USD per milione di token in ingresso, senza addebito per output o cache; possono applicarsi i premi previsti per contesto lungo e regione. Sono condizioni della documentazione Decisions, da verificare al momento dell’implementazione. Il prezzo non comprende automaticamente lavoro di integrazione, archiviazione o revisione delle classificazioni.
L’Italia è presente nei Paesi API supportati. Residenza dei dati, Zero Data Retention e altri regimi dedicati richiedono i requisiti previsti e non derivano automaticamente dall’uso dell’endpoint, come chiarisce la guida del servizio. Per il progetto occorre verificare account, contratto e configurazione effettiva prima di inviare dati aziendali.
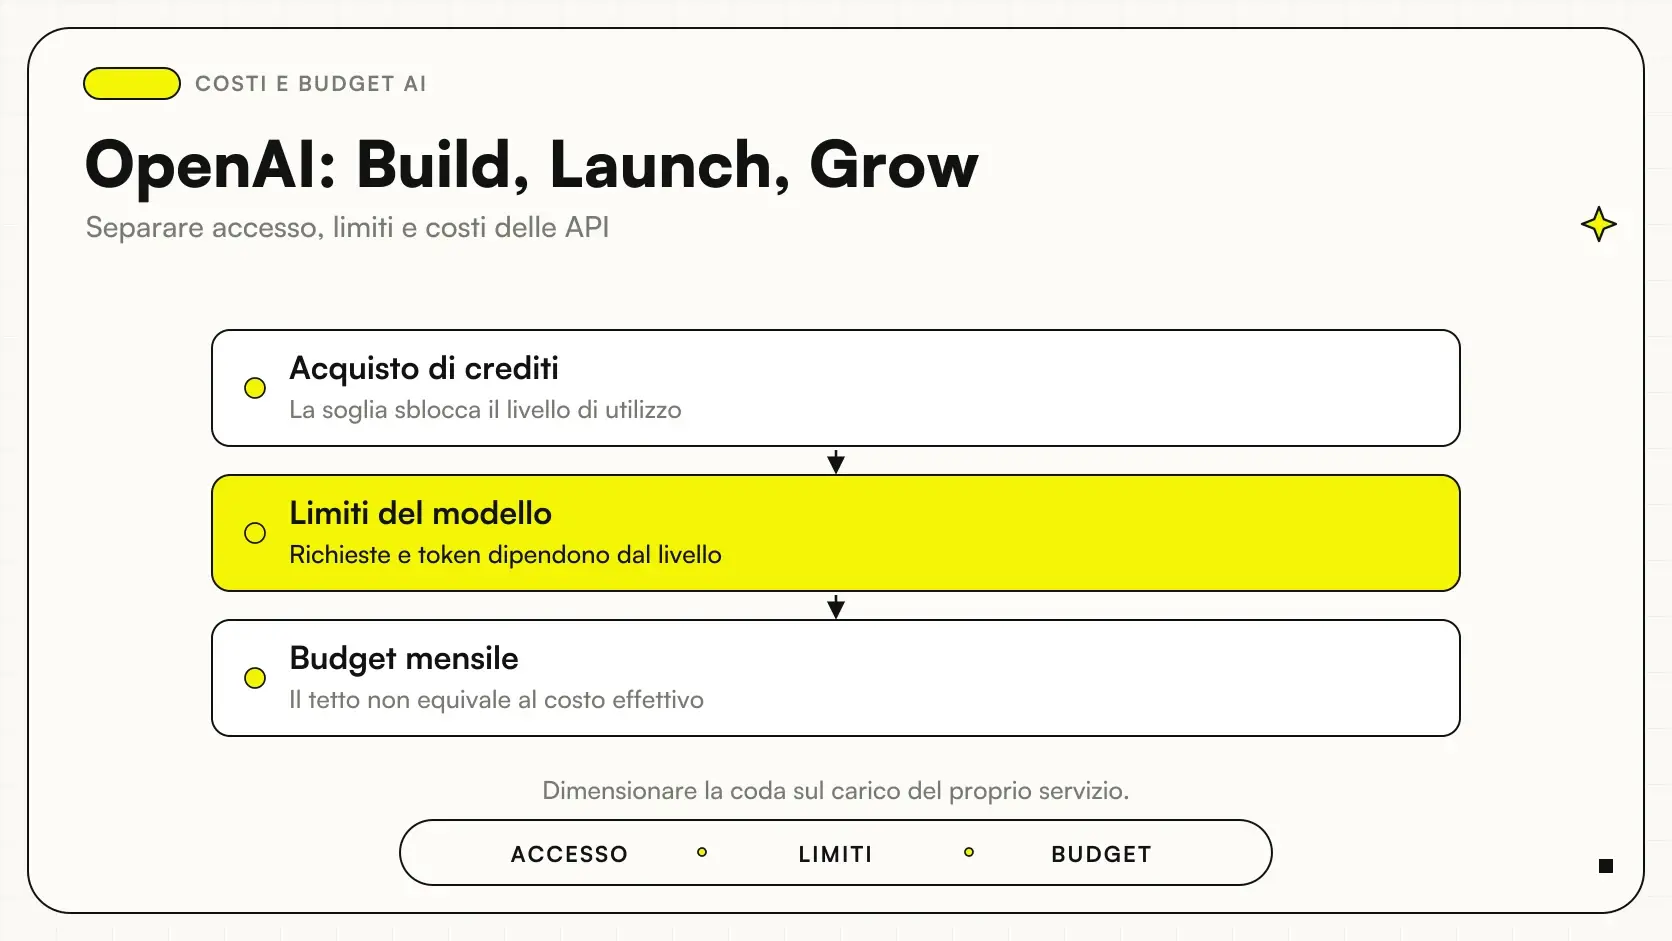
Il consumo deve essere compatibile anche con i limiti API Build, Launch e Grow. Una classificazione economica può comunque fermarsi durante un picco se coda e tentativi non sono gestiti. Il costo e la capacità sono due verifiche distinte, da condurre sullo stesso profilo di traffico previsto.
Quali prove fare prima di assegnare ticket automaticamente?
La prima prova è una esecuzione in parallelo: il sistema classifica, gli operatori continuano il lavoro ordinario e si confrontano gli esiti. La seconda riguarda input difettosi, come immagini illeggibili, allegati mancanti e testi che citano istruzioni estranee alla richiesta. La terza simula un’indisponibilità del servizio. In ogni caso deve esistere una destinazione chiara, senza perdita della pratica e senza falsa conferma di successo.
Gli errori più frequenti sono categorie sovrapposte, soglie copiate da altri progetti, un’unica media di accuratezza e azioni irreversibili collegate direttamente all’etichetta. Anche una buona classificazione può diventare dannosa se il messaggio viene passato al reparto sbagliato da una regola del CRM. Il collaudo deve seguire la richiesta fino al suo stato finale, non fermarsi alla risposta dell’API.
Come leggere una classificazione sbagliata
Confronta input originale, etichetta attesa e categoria proposta. Chiedi se l’istruzione era comprensibile, se le categorie erano distinguibili e se mancava un’informazione. Registra poi la conseguenza operativa: semplice riassegnazione, ritardo o azione impropria. Correggi il livello che ha causato il problema e riprova sul campione tenuto da parte.
Come mantenere affidabili le etichette quando cambia il lavoro?
Il catalogo delle categorie va trattato come un elemento del processo, con un responsabile e una cronologia. Quando viene introdotto un nuovo servizio, i ticket possono non rientrare più nelle definizioni iniziali. Cambiare un’etichetta nel CRM senza aggiornare le istruzioni del classificatore produce una discrepanza silenziosa: l’API restituisce un valore valido, ma la procedura successiva lo interpreta con un significato diverso.
Una modifica dovrebbe quindi includere esempi, regole di destinazione e verifica del campione. Prima di attivarla si conserva la versione precedente e si stabilisce come trattare le pratiche già in coda. Il registro può indicare quale versione delle categorie abbia prodotto ogni proposta, senza salvare inutilmente l’intero contenuto del messaggio nei log tecnici. Questo rende possibile analizzare un errore dopo un aggiornamento senza confondere comportamento vecchio e nuovo.
Anche la revisione umana deve produrre dati coerenti. Se ogni operatore corregge secondo una preferenza personale, il modello viene misurato contro un obiettivo mobile. Una breve discussione dei casi controversi permette invece di migliorare le definizioni e identificare eccezioni. Il responsabile può decidere che alcune richieste restino sempre manuali, perché l’ambiguità è parte del lavoro e non un difetto da eliminare a qualsiasi costo.
La continuità richiede infine una prova periodica sui casi appena arrivati. Un campione storico perfetto non racconta necessariamente le nuove domande dei clienti, le fotografie da un nuovo canale o i messaggi legati a una promozione. L’obiettivo è accorgersi del cambiamento prima che aumentino riassegnazioni e ritardi, mantenendo il classificatore dentro un compito comprensibile al team.
Per confrontare strumenti sullo stesso compito, l’approfondimento su Perplexity Decider e le probabilità nei ticket propone un altro punto di osservazione. Il confronto va fatto usando categorie e campione coerenti, senza dedurre l’affidabilità dalla forma della risposta o dal nome del prodotto.
Quando conviene mantenere una procedura più semplice?
Se il messaggio contiene già un codice esplicito o proviene da un modulo con categoria obbligatoria, una regola deterministica può essere sufficiente. Decisions diventa interessante quando il contenuto è variabile e serve interpretarlo, restando però dentro scelte definite. Prima di introdurlo conviene migliorare il modulo, chiarire le responsabilità dei reparti e verificare se il dato necessario esista già nel gestionale.
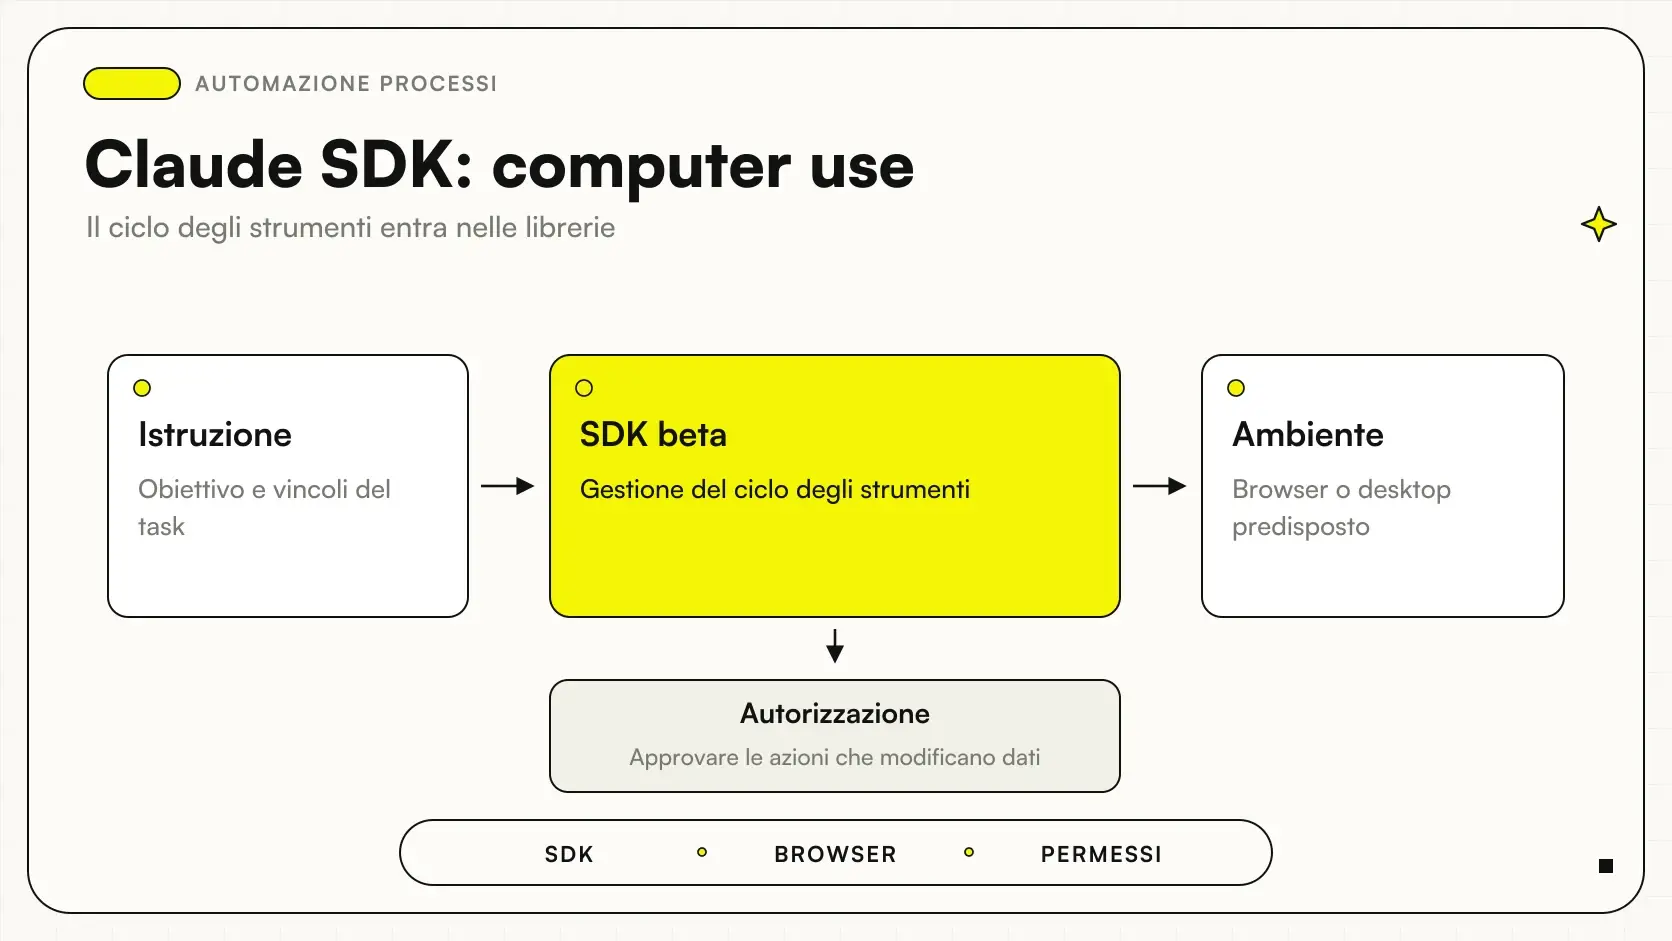
Se invece l’azione passa da un portale senza integrazione, il browser use con Claude SDK riguarda un livello successivo e richiede controlli aggiuntivi. Separare lettura, decisione e azione aiuta a mantenere il progetto proporzionato. Per valutare un pilota su categorie reali e passaggio a operatore, il percorso sugli agenti AI può cominciare da un archivio etichettato e da un solo esito automatizzabile.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Limiti API OpenAI: arrivano Build, Launch e Grow, cosa cambia per le automazioni
 Sonnet 5.5 dimezza il costo di lettura cache: quanto cambia la fattura API
 Claude SDK: nuove classi browser e computer use, cosa serve per automatizzare un gestionale
 API AI: cosa sono e come funzionano
 Agenti AI per aziende: quando servono davvero e come si adottano
 Automazione CRM con AI: come tenere il gestionale aggiornato
 Perplexity Decider 1.1: smistare ticket con probabilità e soglie controllabili
FAQ
Che cosa fa OpenAI Decisions API?
Restituisce decisioni con forme predefinite, utili per classificare o valutare input. Non sostituisce la definizione delle categorie e dei criteri aziendali.
La beta coincide con il primo annuncio?
No. La disponibilità pubblica segue un annuncio precedente. Questo articolo riguarda l’apertura della beta pubblica.
Una probabilità alta garantisce una categoria corretta?
No. Va verificata su esempi etichettati rappresentativi del processo. La soglia di automazione dipende anche dalle conseguenze di un errore.
Può gestire anche immagini?
La guida ufficiale prevede testo e immagini in ingresso. La qualità su allegati specifici deve essere verificata prima dell’uso operativo.
Classificare un ticket significa poterlo chiudere automaticamente?
No. L’etichetta è una proposta decisionale e l’azione successiva richiede regole, permessi e controlli distinti.
Come si valuta un primo pilota?
Con un campione etichettato, una categoria per i casi incerti e una prova in parallelo al lavoro umano. Si misurano gli errori per classe e il costo per richiesta correttamente gestita.