
AQuA di Google: trovare gli errori degli agenti AI anche quando i log sono verdi
AQuA di Google analizza telemetria e difetti degli agenti AI: cosa diagnostica, quali dati servono e perché le correzioni restano da approvare.
Tempo di lettura: 11 min
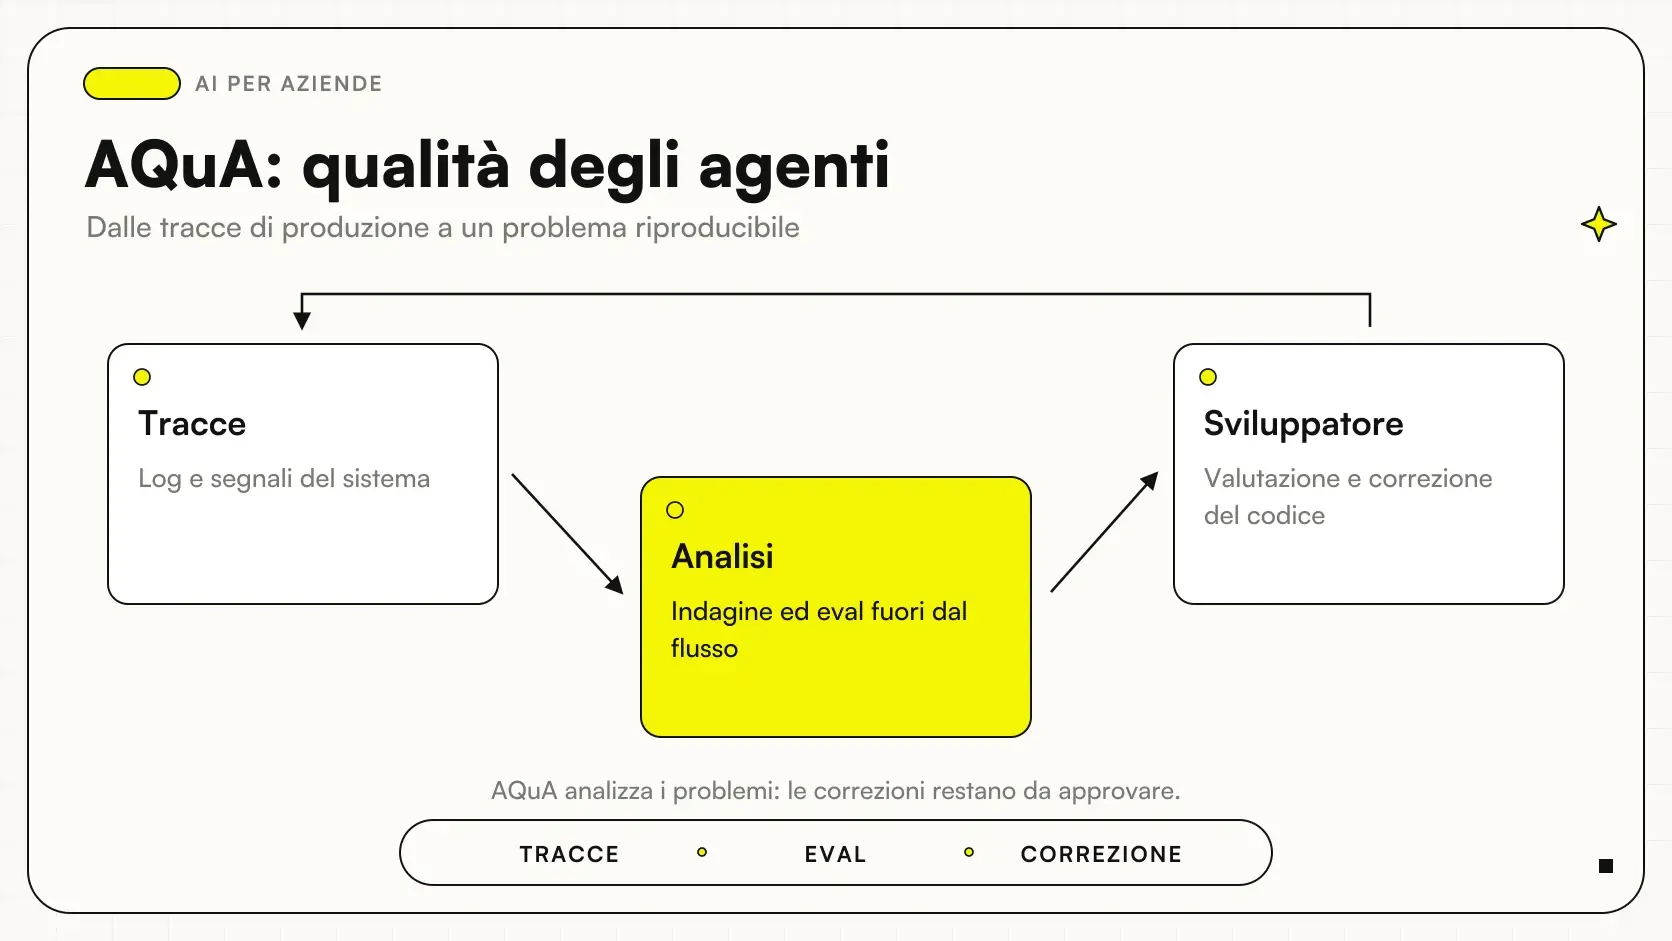
AQuA di Google è un'implementazione per osservare e diagnosticare la qualità degli agenti AI in produzione. Il problema che affronta è concreto: una richiesta può completarsi senza errori tecnici e lasciare comunque l'utente con una risposta sbagliata, un compito incompleto o un'azione poco utile.
L'8 ottobre 2026 Google ha pubblicato il lavoro sull'«outer loop», il ciclo che analizza il comportamento fuori dal percorso delle richieste. AQuA usa telemetria per valutare sessioni e individuare difetti ricorrenti. Non applica correzioni al codice e non apre autonomamente pull request. Annuncio Google Developers.
In sintesi
- Una chiamata riuscita tecnicamente può produrre un risultato aziendale scorretto.
- AQuA analizza sessioni e telemetria fuori dal flusso delle richieste degli utenti.
- La diagnosi può collegare le proposte alla versione di codice distribuita.
- Gli insight richiedono revisione: il sistema non modifica autonomamente l'applicazione.
- Servono strumentazione, accessi ai dati, criteri di qualità e gestione dei costi.
Perché un agente può sbagliare con tutti i log verdi?
I log tecnici rispondono spesso a domande come «il servizio ha risposto?» o «la chiamata è terminata?». Non sempre rispondono a «l'utente ha ottenuto ciò che gli serviva?». Un agente può recuperare un documento esistente ma riferito a un prodotto diverso. Può compilare tutti i campi di una scheda usando una deduzione non autorizzata. Può rispondere con cortesia senza risolvere la richiesta.
Questi difetti possono essere invisibili a un monitoraggio concentrato soltanto sulle eccezioni. L'esecuzione non si interrompe, ma il significato del risultato non corrisponde al compito. Il progetto descritto da Google separa proprio il percorso operativo dall'analisi della qualità: l'osservazione avviene in un ciclo esterno, che esamina sessioni e cerca problemi ricorrenti. Descrizione ufficiale dell'approccio AQuA.
Per un'azienda che usa già agenti AI nei processi, questo cambia la domanda di manutenzione. Non basta sapere che il sistema è raggiungibile. Serve capire quali richieste vengono concluse correttamente, quali richiedono chiarimenti e quali sembrano riuscite soltanto perché non hanno generato un errore informatico. La qualità appartiene al lavoro svolto, non al colore del pannello operativo.
Quali dati analizza l'implementazione AQuA?
L'implementazione legge telemetria da Cloud Trace, Logging e BigQuery, valuta le sessioni, raggruppa difetti e verifica gli insight. Il codice ufficiale descrive un sistema adattabile al proprio progetto Google Cloud. Non è sufficiente installarlo per ottenere automaticamente osservazioni utili: la telemetria deve contenere informazioni che permettano di ricostruire il compito e i passaggi rilevanti. Repository ufficiale AQuA.
Una traccia dovrebbe consentire di collegare richiesta, strumenti utilizzati, fonti consultate e risultato, secondo ciò che il progetto è autorizzato a registrare. Se rimane soltanto una frase finale, può essere difficile capire se il difetto nasce dal recupero delle informazioni, da una regola o da un'integrazione. Anche la versione distribuita conta: una diagnosi riferita al codice sbagliato rischia di suggerire un intervento su un comportamento già cambiato.
Questo non giustifica raccogliere ogni contenuto senza criterio. Prima vanno definiti dati necessari, accessi e conservazione. Una sessione può contenere informazioni personali o riservate, e la sua analisi è a sua volta un trattamento da progettare. La guida alla sicurezza dei dati con l'AI rimane pertinente anche quando l'osservazione avviene nel progetto dell'organizzazione.
Che cosa produce la diagnosi e chi decide la correzione?
Un insight utile collega un problema ricorrente alle sessioni che lo mostrano e alla parte del sistema da esaminare. Non si limita a dire «il prompt potrebbe essere migliore». Deve permettere al responsabile di verificare se la descrizione corrisponde davvero al lavoro atteso e se il cambiamento proposto affronta la causa anziché un sintomo.
Google descrive la possibilità di ancorare le proposte a una fotografia del codice distribuito. AQuA non applica modifiche e non apre autonomamente pull request: il percorso arriva alla diagnosi e alla proposta, lasciando revisione e implementazione al processo del team. Questa distinzione è esplicita nell'annuncio Google Developers e nel README dell'implementazione.
La decisione richiede anche conoscenza del dominio. Un agente potrebbe aver chiesto una conferma perché mancava un requisito essenziale; un valutatore poco contestualizzato potrebbe scambiarlo per inefficienza. Il referente aziendale deve poter spiegare perché l'arresto era corretto. La qualità non coincide sempre con meno passaggi: a volte una domanda in più evita una risposta o un'azione inappropriata.
Qual è la differenza fra errore tecnico e difetto di qualità?
| Situazione osservata | Controllo tecnico | Valutazione del compito |
|---|---|---|
| Fonte non raggiungibile | Chiamata fallita e gestione dell'errore | L'agente spiega il limite senza inventare informazioni? |
| Documento recuperato correttamente | Servizio di ricerca funzionante | Il documento riguarda il caso e la versione giusti? |
| Scheda compilata | Scrittura completata | I campi derivano da dati presenti o da deduzioni? |
| Risposta inviata | Canale operativo | La richiesta è risolta e il testo è appropriato? |
| Escalation a una persona | Passaggio eseguito | Il referente riceve il contesto necessario per intervenire? |
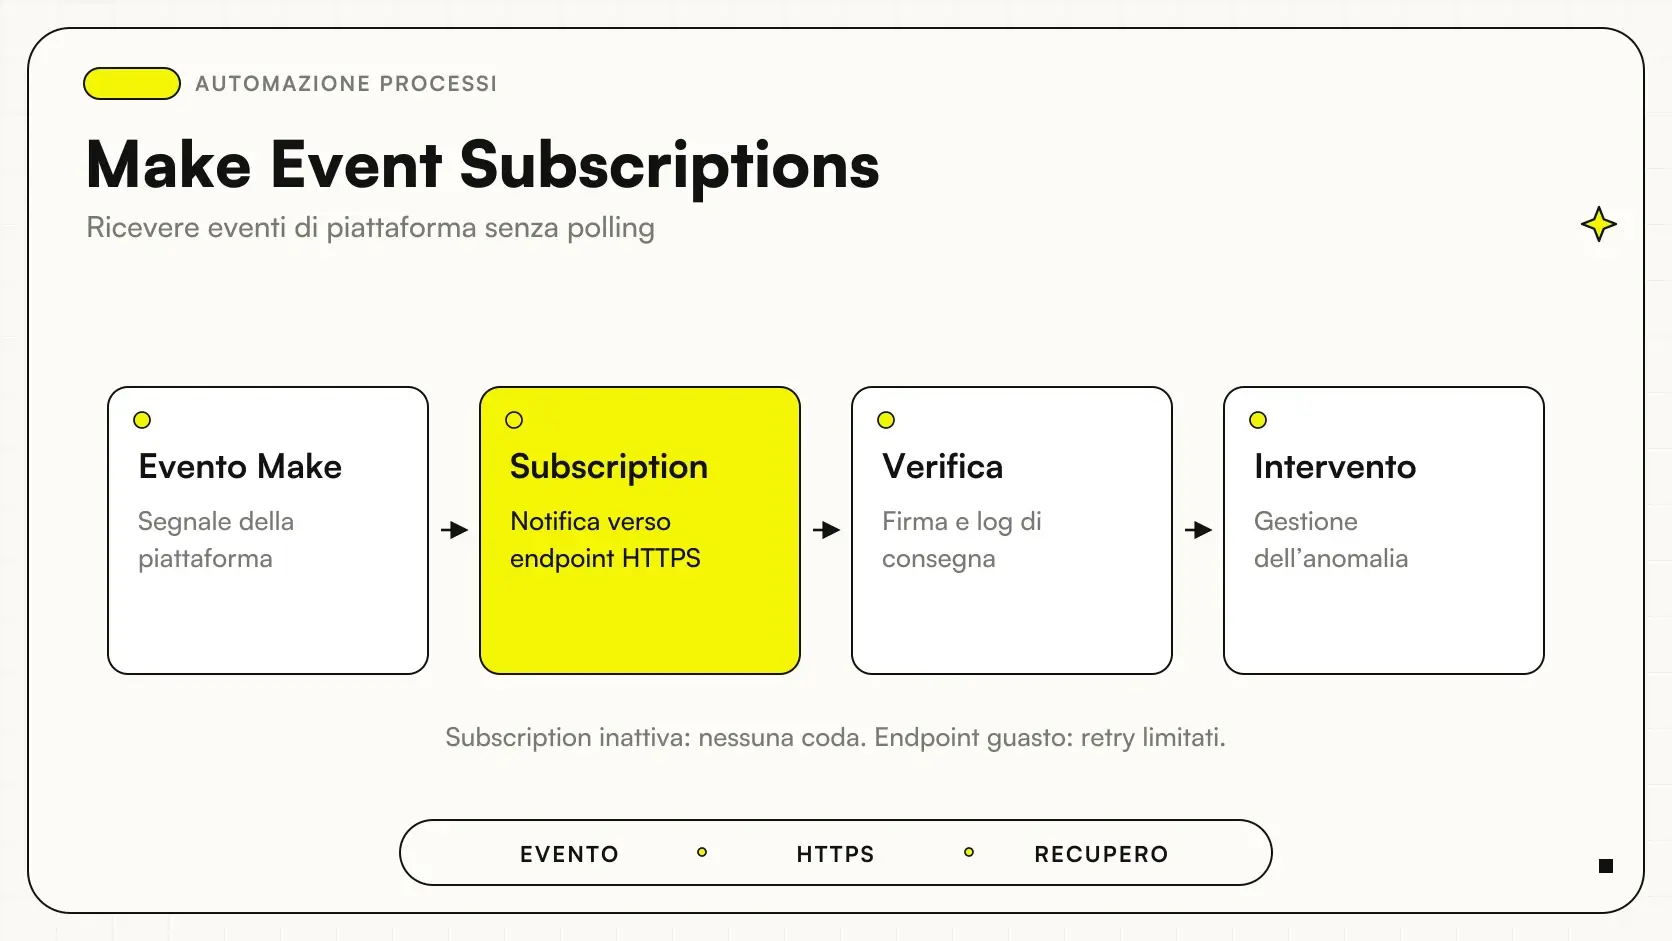
Questi controlli si completano. Non serve abbandonare i log per adottare una valutazione semantica, ma collegarli al risultato atteso. Anche una piattaforma di automazione può segnalare eventi di errore senza sapere se l'informazione trattata sia corretta. Le event subscriptions di Make riguardano il lato operativo di questa osservazione; AQuA affronta un diverso livello di diagnosi degli agenti.
Che cosa dimostra il caso pubblicato da Google?
Il caso illustrato nella pubblicazione utilizza 32 sessioni sintetiche o scriptate. È utile per comprendere il funzionamento della diagnosi, ma non dimostra un miglioramento universale sul traffico di aziende reali. I dati del caso non sono risultati di clienti Giallo né una percentuale di efficacia da trasferire a un progetto diverso. Caso descritto da Google.
Per passare dalla dimostrazione a una prova aziendale serve un insieme di richieste rappresentative. Devono esserci casi riusciti, casi incerti e richieste che l'agente dovrebbe rifiutare o trasferire. Il team annota il comportamento atteso e poi controlla se gli insight individuano problemi reali, ignorano difetti importanti o segnalano falsi problemi. Anche il valutatore va quindi valutato.
Questo lavoro dovrebbe evitare un circuito chiuso in cui un modello giudica un altro modello senza riferimenti esterni. Alcune sessioni vanno lette da persone competenti sul processo, usando criteri condivisi. Se l'agente gestisce un customer care automatizzato, il referente dell'assistenza deve poter distinguere una risposta formalmente completa da una richiesta effettivamente risolta.
L'insight sembra convincente, ma non trovi una sessione che lo dimostri?
Non trattarlo come una correzione pronta. Chiedi evidenze collegabili a richieste, fonti e versione distribuita. Verifica che il comportamento descritto fosse davvero sbagliato secondo le regole del processo. Una proposta plausibile senza riscontro può diventare materiale da approfondire, senza entrare automaticamente nel rilascio.
Un distributore con assistenza tecnica: scenario ipotetico
Immaginiamo un distributore che usa un chatbot per rispondere a domande sui ricambi. Le chiamate ai servizi riescono e i documenti vengono recuperati, ma alcuni utenti ricevono istruzioni riferite a varianti simili del prodotto. In questo scenario ipotetico il problema non apparirebbe necessariamente come eccezione tecnica. La risposta potrebbe essere grammaticalmente corretta e contenere un collegamento reale.
Il responsabile preparerebbe casi che distinguono chiaramente le varianti e richieste in cui manca il codice necessario. Il comportamento atteso potrebbe essere chiedere una precisazione, non completare comunque la risposta. L'analisi dovrebbe cercare il motivo della confusione: fonti recuperate, informazioni passate all'agente e regola di arresto.
Se la diagnosi propone un intervento, il team lo confronterebbe con le sessioni e proverebbe il cambiamento sui casi preparati. Non basterebbe una risposta migliore nella dimostrazione. Occorrerebbe verificare che il sistema non inizi a chiedere chiarimenti inutili quando il codice è presente, o a escludere documenti pertinenti. Il monitoraggio diventerebbe così un ciclo di apprendimento controllato, collegato alle reali responsabilità dell'assistenza.
Una società di servizi con raccolta richieste: scenario ipotetico
Consideriamo una società che usa un agente per raccogliere informazioni e preparare schede per il team operativo. In questo secondo scenario ipotetico le schede vengono salvate correttamente, ma alcune riportano come confermati dettagli che il cliente aveva soltanto ipotizzato. Il flusso termina, il gestionale contiene tutti i campi e nessuna chiamata fallisce: il difetto riguarda il significato delle informazioni.
La prova distinguerebbe dichiarazioni esplicite, informazioni mancanti e deduzioni. Gli insight dovrebbero aiutare a capire se l'agente perde la differenza durante la conversazione o durante la compilazione finale. Un intervento potrebbe riguardare il formato della scheda o il passaggio di conferma, ma andrebbe scelto dopo aver esaminato il percorso, senza attribuire automaticamente il problema al prompt iniziale.
Il responsabile controllerebbe anche ciò che riceve chi prende in carico la richiesta. Una scheda apparentemente completa può essere meno utile di una scheda che segnala chiaramente una lacuna. La guida al chatbot per il sito aziendale aiuta a definire questo confine: il successo non è trattenere la conversazione, ma consegnare al processo un'informazione utilizzabile e correttamente qualificata.
Come trasformare gli insight in un ciclo di manutenzione?
Serve prima un referente che scelga quali problemi affrontare. Un difetto frequente ma poco rilevante può avere priorità diversa da un caso raro con conseguenze importanti. La priorità dovrebbe considerare impatto sul lavoro, possibilità di riprodurre il problema e chiarezza delle evidenze. Non dovrebbe dipendere soltanto da quanto bene il sistema ha scritto la diagnosi.
Poi occorre un percorso fra insight e modifica: verifica, ipotesi, implementazione, prova e rilascio. I casi che hanno mostrato il difetto entrano nella valutazione successiva, insieme a richieste che prima funzionavano. Questo evita di correggere un caso rompendo un altro comportamento. La fotografia del codice distribuito permette di collegare l'osservazione alla versione su cui si interviene, secondo quanto previsto dall'implementazione.
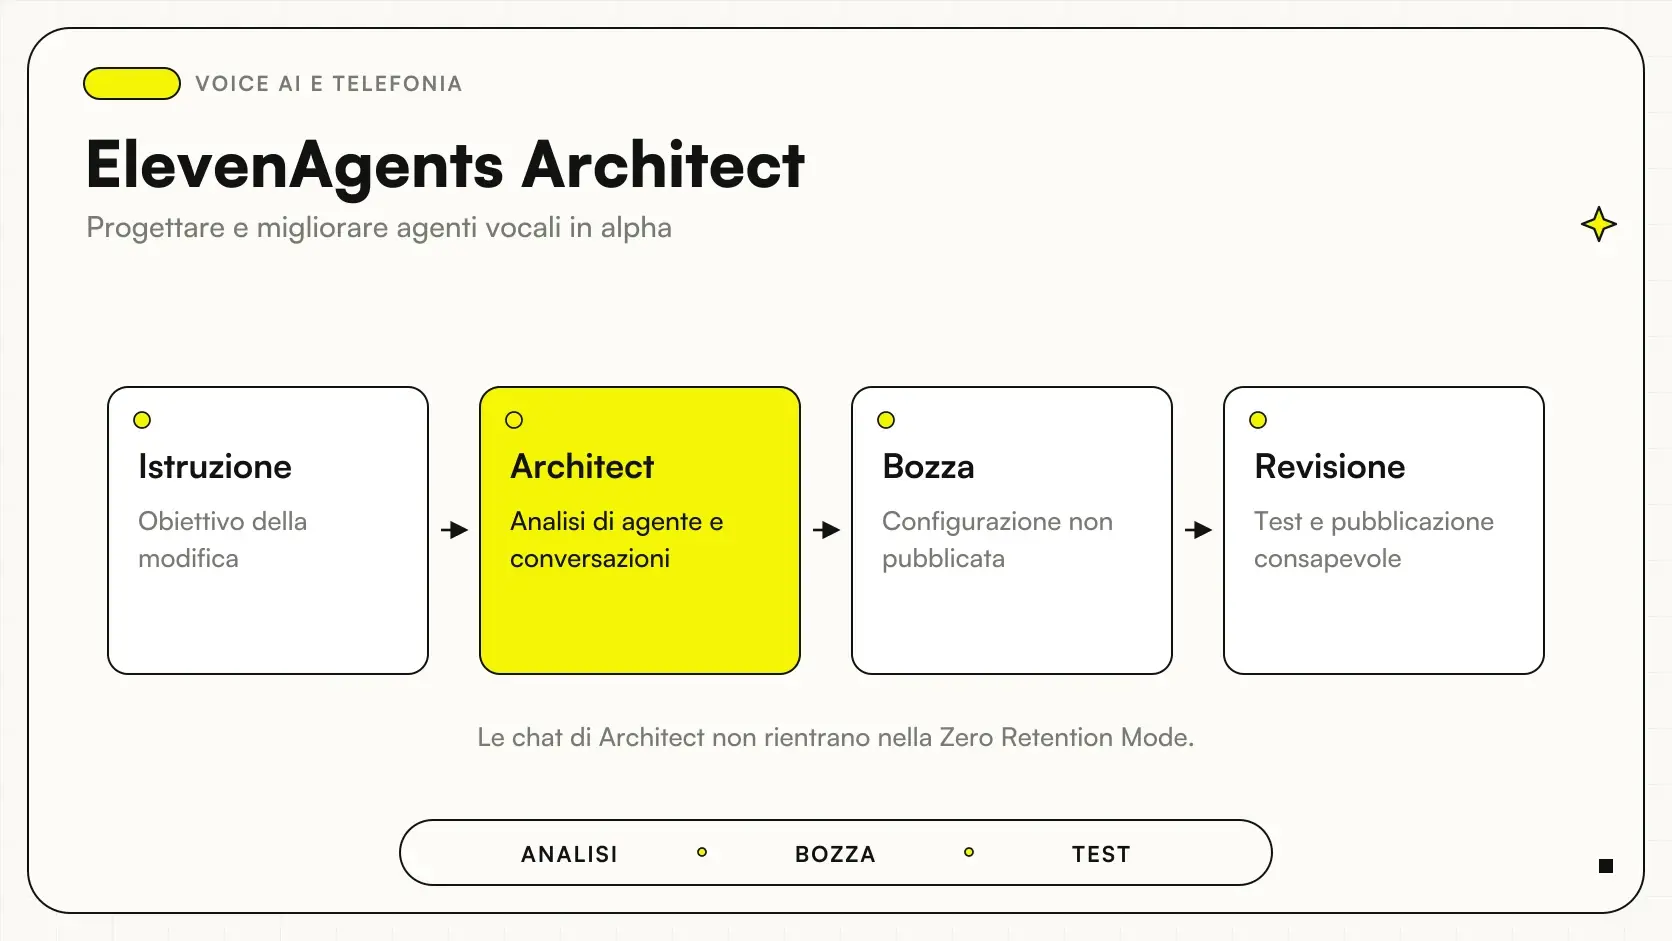
La stessa disciplina serve quando il canale è vocale. Il lavoro descritto per ElevenAgents Architect e test degli agenti vocali riguarda un'altra piattaforma e un'altra esperienza d'uso. Il collegamento utile è mantenere una raccolta di casi e un processo di verifica; non si presume che una diagnosi pensata per una configurazione si trasferisca automaticamente a qualunque agente.
Come distinguere un difetto ripetuto da una richiesta fuori perimetro?
Non ogni insoddisfazione indica che l'agente debba fare di più. Una richiesta può essere fuori dal servizio previsto, oppure richiedere un'autorizzazione che l'utente non possiede. Prima di accettare una diagnosi, il team dovrebbe leggere il compito insieme alle regole operative. Altrimenti si rischia di correggere un comportamento che protegge il processo, come chiedere conferma prima di un'azione o non mostrare una fonte riservata.
Per rendere la distinzione verificabile, conviene annotare il motivo per cui un caso è accettabile o difettoso. «Risposta poco utile» è una descrizione debole; «non ha chiesto il codice necessario a distinguere le varianti» identifica una regola osservabile. Allo stesso modo, «non ha completato la richiesta» può essere corretto se manca un'informazione obbligatoria. La diagnosi dovrebbe aiutare a vedere questa differenza, non appiattirla in un giudizio generale.
Un difetto ricorrente merita poi un controllo su sessioni diverse. Se compare solo con una fonte superata, la prima azione può essere aggiornare l'archivio. Se compare con fonti corrette e richieste chiare, il team esamina i passaggi dell'agente. Questa separazione evita di riscrivere istruzioni per compensare un problema dei dati. Permette anche di assegnare il lavoro alla persona giusta: proprietario delle fonti, responsabile dell'integrazione o sviluppatore dell'agente.
Quali errori evitare prima di attivare l'osservazione?
Il primo è presentare il codice pubblicato come un servizio gestito già pronto, con una promessa di correzione automatica. Il secondo è registrare dati senza aver deciso chi può leggerli e per quanto tempo. Il terzo è fidarsi di qualsiasi insight senza collegarlo a sessioni e comportamento atteso. La disponibilità del codice permette di adattarlo, non elimina queste responsabilità.
Un altro errore è dimenticare i costi della stessa osservazione: preparazione dei dati, servizi utilizzati, chiamate ai modelli e revisione delle proposte. Non viene fornita qui una tariffa universale, perché dipende dal progetto e dal consumo. Prima di estendere l'analisi, conviene capire quali sessioni includere e come rendere gli esiti gestibili dal team.
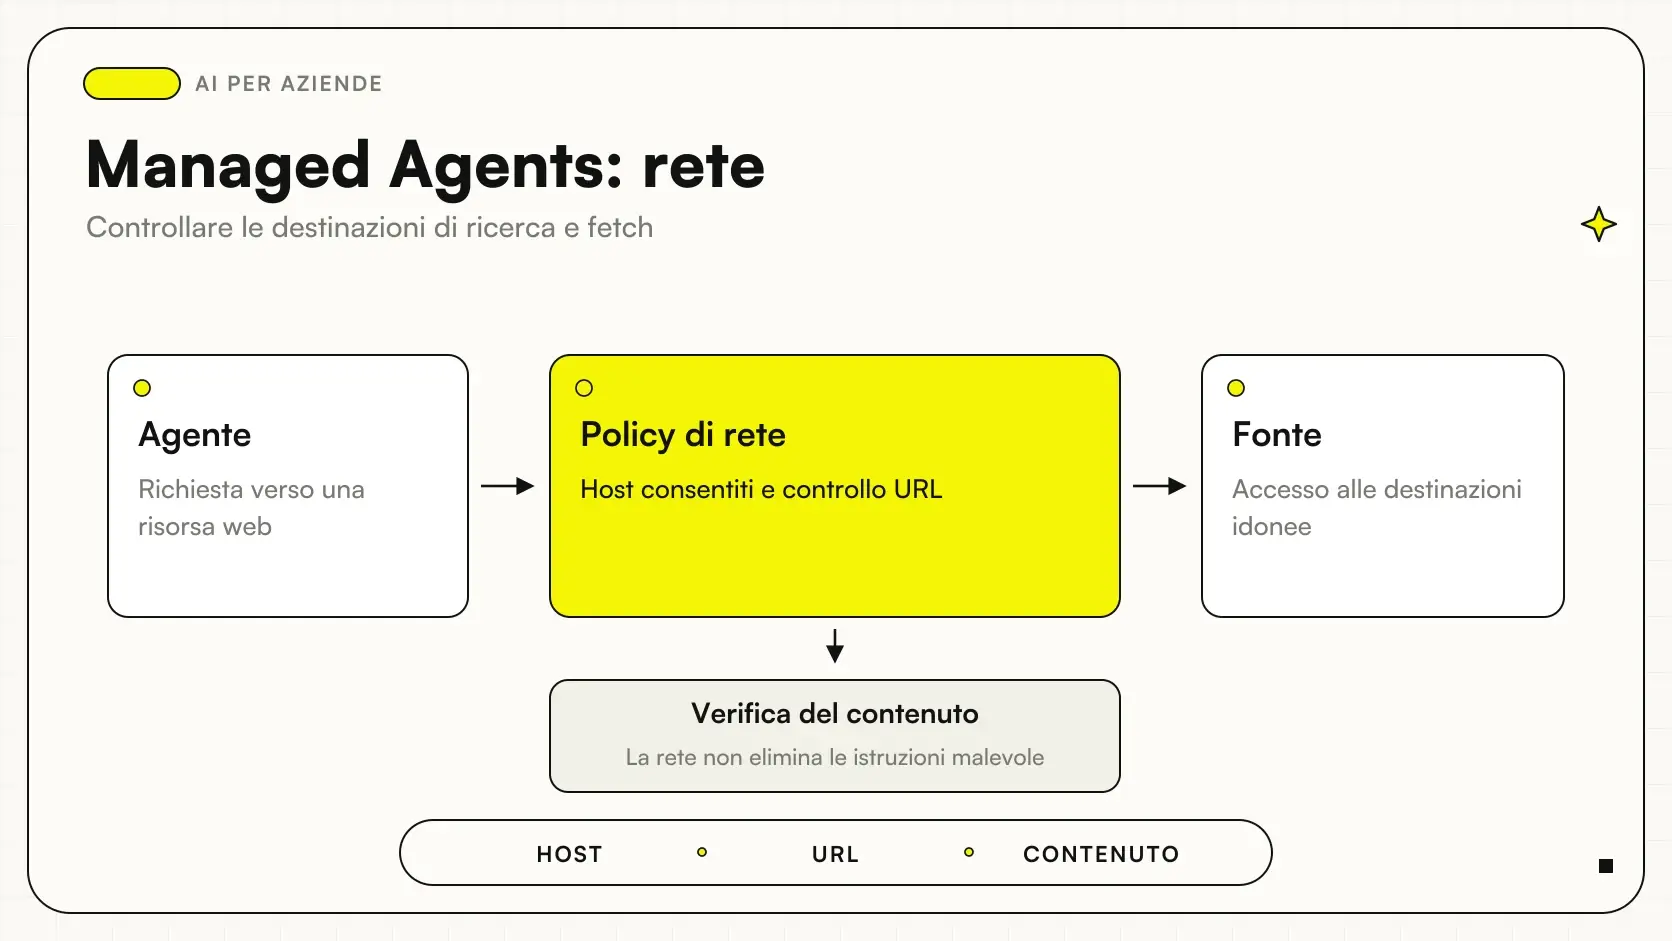
Infine, l'osservatore deve avere accessi coerenti con il suo compito. La discussione sulla rete e web fetch nei Claude Managed Agents mostra un diverso confine di sicurezza: quali fonti e servizi un agente può raggiungere. Anche nella diagnosi serve una mappa esplicita delle autorizzazioni, senza credenziali ampie assegnate soltanto per rendere più semplice l'integrazione.
Se hai già un agente attivo, possiamo impostare un percorso di manutenzione e controllo qualità partendo da richieste rappresentative, telemetria necessaria e responsabilità di revisione. AQuA è interessante quando aiuta a spiegare un difetto con evidenze verificabili. Il risultato da cercare è sapere cosa correggere, perché e come dimostrare che il cambiamento abbia migliorato il lavoro.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
 Agenti AI per aziende: quando servono davvero e come si adottano
 Chatbot per sito web aziendale: come funziona e conviene
 Automazione customer care: quando l'AI risponde al posto tuo
 AI e sicurezza dei dati: rischi concreti e come gestirli
 Make Event subscriptions: ricevere avvisi quando un’automazione fallisce
 ElevenAgents Architect: progettare e correggere agenti vocali con test e bozze
 Claude Managed Agents estende i limiti di rete a ricerca e web fetch
FAQ
Che cos’è AQuA di Google?
È un’implementazione adattabile per osservare e diagnosticare la qualità degli agenti in produzione. Lavora sulla telemetria fuori dal percorso delle richieste degli utenti.
AQuA corregge automaticamente il codice?
No. La diagnosi può ancorare proposte al codice distribuito, ma non applica modifiche né apre autonomamente pull request. Le proposte richiedono revisione e verifica.
Quali fonti di telemetria usa AQuA?
L’implementazione descritta usa Cloud Trace, Logging e BigQuery. La disponibilità di dati utili dipende dalla strumentazione e dalle autorizzazioni del progetto.
AQuA è un prodotto gestito già pronto?
La pubblicazione riguarda codice adattabile nel proprio progetto Google Cloud. Non va presentata come una promessa di servizio gestito GA o di correzione automatica.
I log senza errori dimostrano che un agente lavora bene?
No. Una chiamata può riuscire tecnicamente e produrre una risposta o un’azione inappropriata. Per giudicare la qualità servono contesto del compito e criteri di risultato.
Come si verificano le diagnosi di AQuA?
Si collegano gli insight alle sessioni pertinenti, alle fonti e alla versione distribuita. Dopo la revisione, un’eventuale modifica va provata su casi rappresentativi prima del rilascio.