
Token AI: cosa sono e perché pesano su costi e lunghezza delle risposte
Cosa sono i token AI, come entrano nella finestra di contesto e perché influiscono su limiti di utilizzo, lunghezza delle chat e costi di una PMI.
I token sono le unità con cui un modello linguistico legge e scrive. Non vede frasi o pagine come le vediamo noi: vede una sequenza di pezzetti di testo, e ogni pezzetto è un token. Più testo entra e più testo esce, più token si consumano.
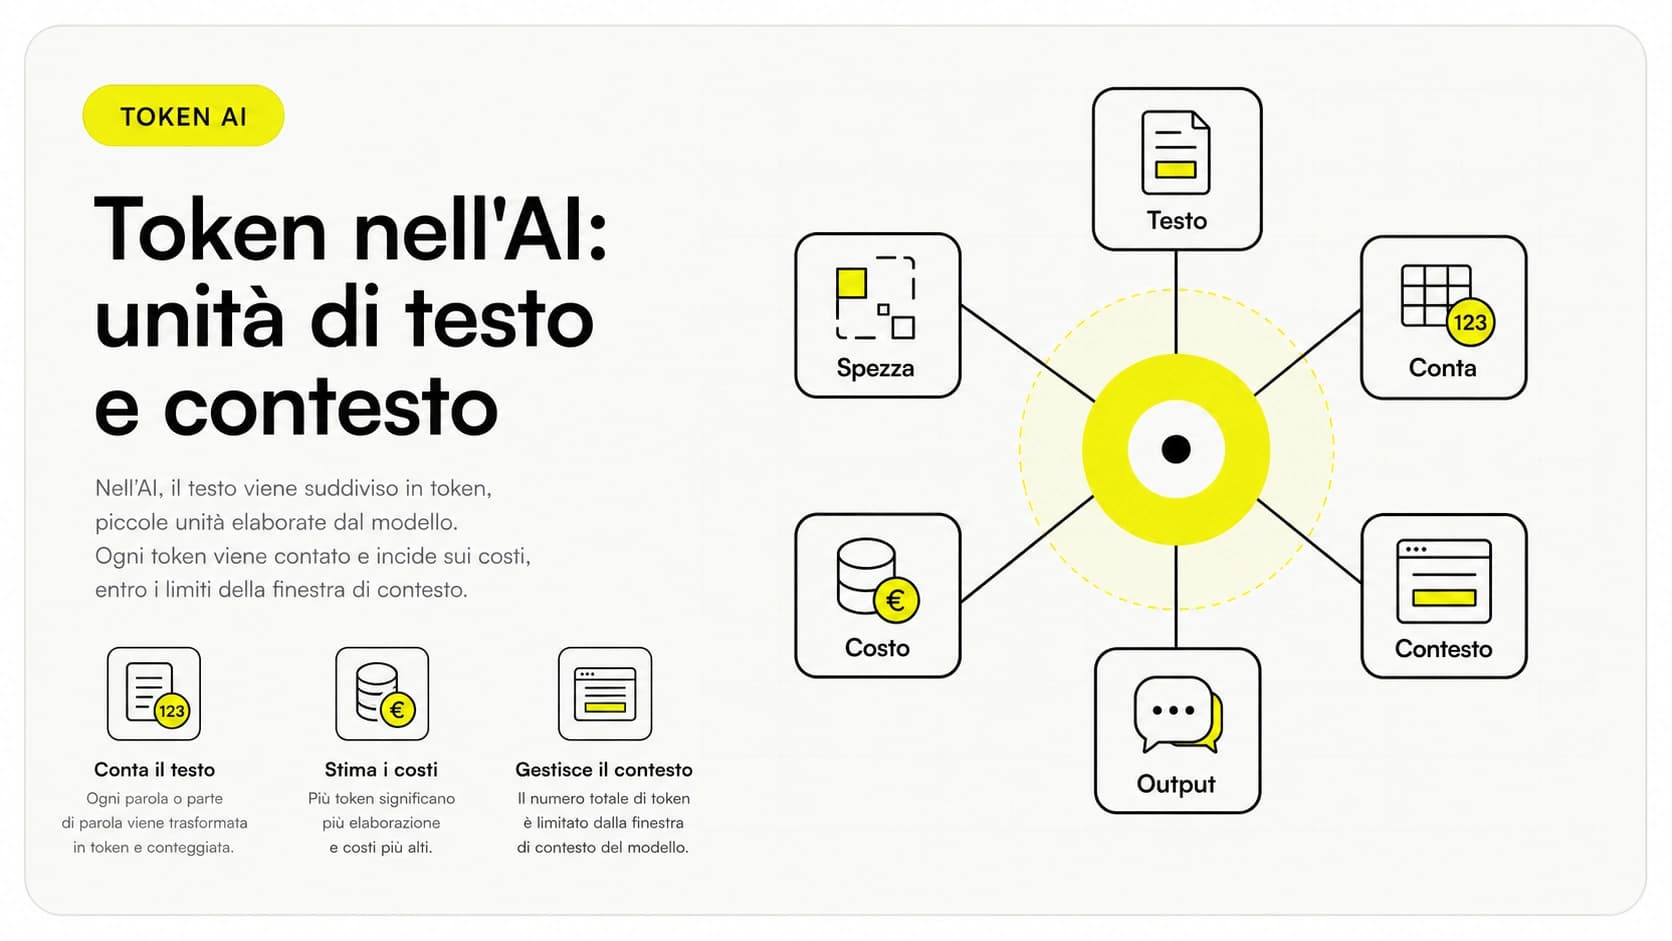
La definizione, nel glossario di Claude, è netta: i token sono le unità individuali più piccole di un modello linguistico e possono corrispondere a parole, sottoparole, caratteri o persino byte nel caso di Unicode. Di solito restano nascosti, perché noi scriviamo in forma di testo. Diventano importanti quando si guardano gli input e gli output esatti, cioè quando si parla di limiti, di lunghezza delle risposte e di costi.
Questo articolo spiega prima l'idea, poi il meccanismo: come il testo diventa token, che cosa entra nella finestra di contesto, perché una chat troppo lunga peggiora e dove i token toccano il budget di una PMI. Per un taglio più introduttivo su conteggio e costi puoi leggere anche cosa sono i token AI e come si contano; qui ci concentriamo sul legame con limiti e lunghezza delle risposte.
In sintesi
- Un token è l'unità minima che il modello elabora: può essere una parola, una sottoparola, un carattere o un byte.
- Quanti caratteri stanno in un token dipende dal modello e dalla lingua, quindi serve contare con il modello che userai davvero.
- La finestra di contesto comprende tutto: prompt di sistema, messaggi, documenti, strumenti e anche la risposta.
- Più contesto non è automaticamente meglio: oltre una certa lunghezza accuratezza e richiamo si degradano.
- Limiti di utilizzo e limiti di lunghezza sono cose diverse: la quantità nel tempo contro la profondità di una singola conversazione.
Che cosa sono i token dell'AI, in parole semplici?
Pensa a un modello linguistico come a qualcuno che legge solo attraverso tessere. Prima di rispondere, il tuo testo viene spezzato in tessere, il modello lavora su quelle e produce la risposta nello stesso modo, una tessera dopo l'altra. Questa è un'analogia nostra, non una definizione delle fonti, ma aiuta a ricordare il punto: il modello non conta le parole, conta le tessere.
Il glossario descrive esattamente questo passaggio: quando a Claude viene dato un testo da valutare, quel testo, fatto di una serie di caratteri, viene codificato in una serie di token che il modello elabora. Una parola comune può essere un solo token, una parola lunga o rara può essere spezzata in più parti.
Per chi gestisce un'azienda la conseguenza pratica è semplice. Quando uno strumento parla di "lunghezza", "limiti" o "consumo", sta quasi sempre parlando di token e non di pagine, righe o parole.
Quanti caratteri entrano in un token?
Non esiste una risposta unica. Secondo il glossario di Claude, per Claude il numero di caratteri rappresentato da un token dipende dal modello e dalla lingua. Lo stesso documento riporta che i modelli Claude 4.7 e successivi e Claude Mythos Preview usano un tokenizer più recente, che produce circa il 30 percento di token in più per lo stesso testo rispetto ai modelli precedenti, nei quali un token rappresenta circa 3,5 caratteri inglesi.
Due cose da non sovrapporre. La stima di circa 3,5 caratteri riguarda l'inglese e i modelli precedenti. Per l'italiano le fonti che abbiamo consultato non indicano una cifra ufficiale, quindi non ne ricaviamo una regola a spanne. E lo stesso testo può costare più token cambiando semplicemente modello.
La strada indicata dalla documentazione è pratica: per ottenere conteggi esatti si usa il conteggio dei token con il modello che si intende utilizzare, come spiega ancora il glossario. Per stimare una richiesta prima di inviarla c'è l'API di conteggio dei token, descritta nella pagina sulle finestre di contesto.
Che cos'è la finestra di contesto e che cosa ci finisce dentro?
La finestra di contesto è tutto il testo che il modello può consultare quando genera una risposta, risposta compresa. Lo dice la documentazione sulle finestre di contesto. Un'analogia, anche questa nostra: è la scrivania su cui il modello lavora. Quello che non è sulla scrivania, non lo vede.
Sulla scrivania finisce più di quanto si pensi. Secondo la stessa pagina, viene conteggiato tutto ciò che è presente nella richiesta: il prompt di sistema, ogni messaggio (inclusi risultati degli strumenti, immagini e documenti) e le definizioni degli strumenti. Conta anche l'output generato per quel turno, incluso il ragionamento esteso.
Da ricordare. La risposta non è un extra gratuito: occupa spazio nella stessa finestra della domanda. Una domanda enorme lascia meno spazio per rispondere.
Per l'app di chat vale lo stesso principio. Il Centro assistenza Anthropic spiega che i limiti di lunghezza si riferiscono alla finestra di contesto, cioè alla quantità di informazioni con cui Claude può lavorare in una singola chat. Una parte è sempre riservata alla risposta, quindi la conversazione più lunga possibile è leggermente più piccola della finestra completa.
Quanto è grande la finestra di contesto?
Dipende dal modello. Per l'app, il Centro assistenza indica che sui piani a pagamento i modelli più recenti supportano una finestra fino a 1M token, mentre altri ne supportano 500K o 200K. Il valore esatto per il tuo caso va verificato sul modello e sul piano che usi, perché cambia nel tempo.
Se vuoi capire quanto questa dimensione conti davvero nella scelta di un modello, l'articolo sulla finestra di contesto a confronto mette la questione in prospettiva.
Perché una chat molto lunga risponde peggio?
Perché più contesto non è automaticamente meglio. La documentazione sulle finestre di contesto osserva che una finestra più ampia consente di gestire prompt più complessi e lunghi, ma che man mano che il numero di token cresce l'accuratezza e il richiamo si degradano. Il fenomeno si chiama context rot, deterioramento del contesto.
In pratica: incollare tutto "per sicurezza" non è una buona strategia. Se la chat ha accumulato bozze scartate, allegati non più utili e deviazioni, il modello deve lavorare in mezzo a quel rumore. Spesso conviene aprire una conversazione nuova con un riassunto pulito di ciò che serve.
Come i token influiscono su limiti di utilizzo e costi?
Qui conviene distinguere due tipi di limite. Sempre secondo il Centro assistenza Anthropic, i limiti di utilizzo riguardano la quantità nel tempo, mentre i limiti di lunghezza riguardano la profondità e la complessità delle singole conversazioni. Sono due contatori diversi.
Sul consumo pesano più fattori: la lunghezza e la complessità delle conversazioni, le funzioni usate, il modello scelto e il livello di impegno selezionato. Un impegno più elevato utilizza più token. Strumenti e connettori richiedono molti token, quindi gestirli aiuta sia a massimizzare la finestra disponibile sia a ottimizzare i limiti.
| Elemento | Cosa fa ai token | Dove si legge |
|---|---|---|
| Testo che scrivi e documenti allegati | Entra nella finestra come input | Finestre di contesto |
| Prompt di sistema e definizioni degli strumenti | Occupano contesto a ogni richiesta | Finestre di contesto |
| Risposta e ragionamento esteso | Contano nella finestra e come output | Finestre di contesto |
| Livello di impegno più alto | Usa più token | Centro assistenza Anthropic |
| Strumenti e connettori attivi | Richiedono molti token | Centro assistenza Anthropic |
Per chi usa l'API c'è un dettaglio di fatturazione. Ogni risposta riporta il consumo nel campo usage, e la pagina sulle finestre di contesto precisa che i token di thinking sono fatturati come token di output una sola volta, quando vengono generati. Sui modelli che mantengono i blocchi di thinking precedenti, quei blocchi entrano poi nell'input delle richieste successive e sono fatturati come token di input, come il resto della cronologia.
I prezzi per token non sono nelle fonti che abbiamo usato: vanno letti nella pagina prezzi ufficiale del fornitore. Per capire come si traducono in budget c'è il prezzo per milione di token spiegato e, per i modelli Claude, il listino messo a confronto con il costo del lavoro.
Come si presenta il problema in una PMI vera?
Ecco due esempi ipotetici, costruiti per spiegare il meccanismo. Non sono casi di clienti.
Uno studio di commercialisti. Una collaboratrice apre una chat al mattino, vi incolla un contratto, poi una circolare, poi una serie di email, e continua a fare domande per tutta la giornata. Verso sera le risposte diventano meno precise e il limite di utilizzo si avvicina. Il meccanismo è quello descritto sopra: tutto il materiale resta nella finestra e il deterioramento del contesto si fa sentire. Il rimedio è lavorare per pratica: una conversazione per documento, con un breve riassunto portato nella successiva.
Un negozio online artigianale. Il titolare collega all'assistente più strumenti e connettori "per comodità", anche se per descrivere i prodotti ne basterebbe uno. Ogni definizione e ogni risultato degli strumenti occupa contesto e consuma token. Disattivare ciò che non serve libera spazio per il lavoro vero. Se poi il negozio usasse l'API, lo stesso ragionamento si trasferirebbe sul costo a richiesta.
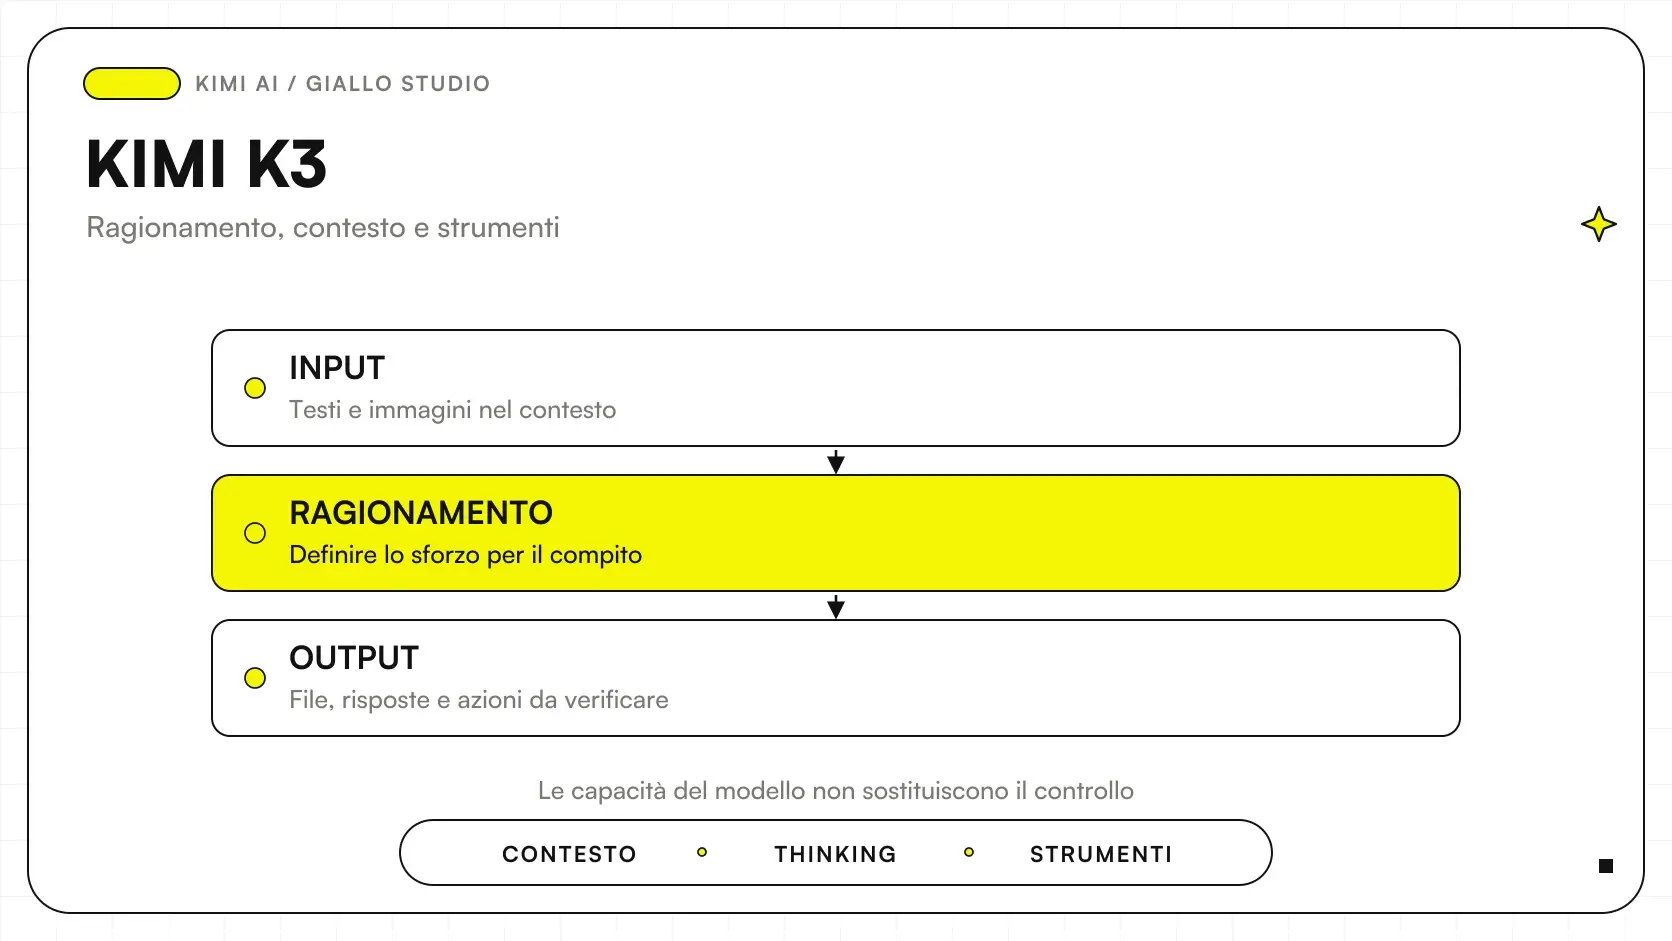
Per un'idea di come si valuta un altro modello con la stessa griglia, puoi leggere come si presentano ragionamento e limiti pratici in Kimi. Per vedere come lo stesso tema si manifesta dentro uno strumento per sviluppatori, esiste un pezzo dedicato a leggere la finestra di contesto in Claude Code.
Quali errori evitare con i token?
Ragionare in pagine invece che in token
Succede perché pagine e parole sono le unità che conosciamo. Il problema è che il modello non le usa, e il conteggio cambia con modello e lingua. Per evitarlo, conta sul modello che userai davvero.
Dare per scontata una regola fissa sull'italiano
Capita di sentire stime tonde, ma le fonti non ne forniscono una per l'italiano. Eviti l'errore misurando un campione dei tuoi testi con lo strumento di conteggio ufficiale.
Tenere una sola chat infinita
È comodo, ma il contesto si riempie e la qualità cala. Apri conversazioni nuove quando cambia il compito e porta con te solo ciò che serve.
Lasciare attivi strumenti e connettori inutili
Si fa per abitudine o per timore di non avere qualcosa a portata di mano. Eppure, come ricorda il Centro assistenza, richiedono molti token. Attiva solo quelli utili al compito.
Confondere limite di utilizzo e limite di lunghezza
Sembrano lo stesso blocco ma non lo sono: uno misura la quantità nel tempo, l'altro la profondità di una conversazione. Capire quale dei due ti ferma ti dice se serve aspettare o aprire una nuova chat.
Come applicarlo in azienda, passo dopo passo?
Prima di partire
- Sai quale modello e quale piano userete.
- Hai a portata di mano la pagina prezzi ufficiale del fornitore.
- Hai scelto tre o quattro testi tipici del vostro lavoro da usare come campione.
- Sai quali strumenti e connettori servono davvero.
I passi
- Prendi i testi campione e misurali con il conteggio dei token del modello scelto, senza fidarti di stime generiche.
- Guarda il campo usage nelle risposte, se usi l'API, per vedere cosa consuma una richiesta reale.
- Chiedi risposte della lunghezza adeguata: una risposta più lunga del necessario consuma token senza aggiungere valore.
- Spegni strumenti e connettori non necessari e apri una nuova conversazione quando la chat si allunga.
- Solo a questo punto stima un budget, con i prezzi letti sul sito del fornitore, e rivedilo dopo qualche settimana di uso.
Cosa può andare storto: usare un campione non rappresentativo, dimenticare che un modello più recente può contare più token per lo stesso testo, oppure stimare i costi con prezzi non aggiornati. Per un metodo di calcolo più ampio, come si calcola il costo delle API completa il quadro.
Da dove cominciare?
Partire dalla misura, non dall'intuizione: pochi testi reali, il modello scelto e i dati ufficiali bastano a togliere gran parte delle sorprese. Se vuoi un confronto con qualcuno che conosce i tuoi processi, parlane con noi nella pagina di consulenza AI.
Metodo e fonti delle guide di Giallo Studio
Come lo applichiamo in azienda
Risorse correlate
FAQ
Un token è la stessa cosa di una parola?
No. Un token può corrispondere a una parola, ma anche a una sottoparola, a un carattere o a un byte. Una parola lunga o rara può quindi essere divisa in più token.
Quanti token servono per un testo in italiano?
Le fonti consultate non riportano una cifra ufficiale per l'italiano. Il numero di caratteri per token dipende dal modello e dalla lingua. Per un dato affidabile conviene usare il conteggio dei token con il modello che intendi utilizzare.
Perché la risposta dell'AI viene tagliata o la chat si blocca?
Può dipendere dal limite di lunghezza, cioè dalla finestra di contesto, che include anche lo spazio riservato alla risposta. Oppure dal limite di utilizzo, che riguarda la quantità nel tempo. Sono due limiti diversi e si risolvono in modo diverso.
Più contesto significa sempre risposte migliori?
No. Una finestra ampia permette prompt più lunghi, ma man mano che i token crescono accuratezza e richiamo si degradano. Questo fenomeno si chiama context rot.
Il ragionamento esteso consuma token?
Sì. L'output generato per il turno, ragionamento esteso incluso, viene conteggiato nella finestra di contesto. Via API, i token di thinking sono fatturati come token di output una sola volta, quando vengono generati.
Come stimo il consumo prima di spendere?
Usa l'API di conteggio dei token sul modello scelto e controlla il campo usage nelle risposte. I prezzi per token vanno letti sulla pagina ufficiale del fornitore. Con questi due dati puoi costruire una stima prudente.