
Cluster · tempo al primo token
Tempo al primo token: cos'è e perché decide la percezione di velocità
Cos'è il tempo al primo token (TTFT), perché conta più della velocità totale, cosa lo peggiora e come si riduce in un sistema AI aziendale.
Tempo di lettura: 10 min
Guida operativa · Fondamenta AI

Il tempo al primo token — spesso abbreviato TTFT, dall'inglese time to first token — è il tempo che passa fra l'invio della richiesta e la comparsa del primo pezzo di risposta. È il tempo in cui l'utente guarda uno schermo fermo, senza sapere se sta succedendo qualcosa.
È una metrica diversa dalla velocità complessiva, e per l'esperienza d'uso è quasi sempre la più importante delle due. Un sistema che inizia a rispondere subito e poi procede con calma viene percepito come veloce; uno che pensa a lungo e poi consegna tutto insieme viene percepito come lento, anche quando finisce prima.
Capirlo serve a due cose concrete: scegliere il modello giusto per un'interfaccia usata da persone, e sapere dove intervenire quando gli utenti si lamentano che "l'AI è lenta".
In sintesi
- Il TTFT è l'attesa prima che compaia la prima parola.
- Per chi guarda lo schermo è il numero che conta di più.
- La causa principale è la lunghezza del prompt, non la potenza del modello.
- La cache è la leva più efficace quando il prompt si ripete.
- Nei processi automatici conta poco: lì pesano costo e tempo totale.
- Si misura sui casi peggiori, non sulla media.
Le due metriche che non vanno confuse
Quando si parla di velocità di un modello si mescolano due numeri che si comportano in modo diverso.
| Metrica | Cosa misura | Chi la sente |
|---|---|---|
| Tempo al primo token | Attesa prima della prima parola | L'utente davanti allo schermo |
| Velocità di generazione | Quante parole al secondo escono dopo | Chi legge risposte lunghe |
La somma delle due dà il tempo totale, ma le due voci non si ottimizzano allo stesso modo e non pesano allo stesso modo. Per una risposta breve domina il tempo al primo token. Per un documento lungo pesa anche la velocità di generazione, perché il testo deve finire di uscire.
C'è un terzo numero, spesso decisivo nella pratica: la variabilità. Un servizio che risponde di solito in un secondo ma ogni tanto in dieci viene percepito come inaffidabile più di uno costantemente un po' lento.
Perché decide la percezione di velocità
Le risposte compaiono progressivamente, parola dopo parola. Questo cambia completamente la psicologia dell'attesa: appena arriva il primo pezzo, l'utente inizia a leggere, e da quel momento la generazione prosegue mentre lui è occupato.
Il risultato è controintuitivo: fra due sistemi, quello che comincia a rispondere prima sembra più veloce anche se impiega complessivamente più tempo. L'attesa che pesa davvero è solo quella iniziale, perché è l'unica in cui l'utente non ha niente da fare.
Cosa lo peggiora
In ordine di quanto pesa nella pratica.
- La lunghezza di quello che mandi. Prima di produrre la prima parola il modello deve elaborare tutto il prompt. Un contesto molto lungo si paga in attesa, oltre che in denaro.
- Il livello di ragionamento richiesto. Se il modello è impostato per ragionare a lungo prima di rispondere, quel tempo si somma tutto all'attesa iniziale.
- La coda del servizio. Quando il fornitore è carico, la richiesta aspetta prima ancora di essere elaborata. È la causa più frequente dei picchi anomali.
- La distanza del server. Il viaggio dei dati aggiunge tempo fisso: conta soprattutto quando tutto il resto è già veloce.
- I passaggi intermedi. In un sistema che prima cerca documenti e poi interroga il modello, l'attesa percepita include anche la ricerca.
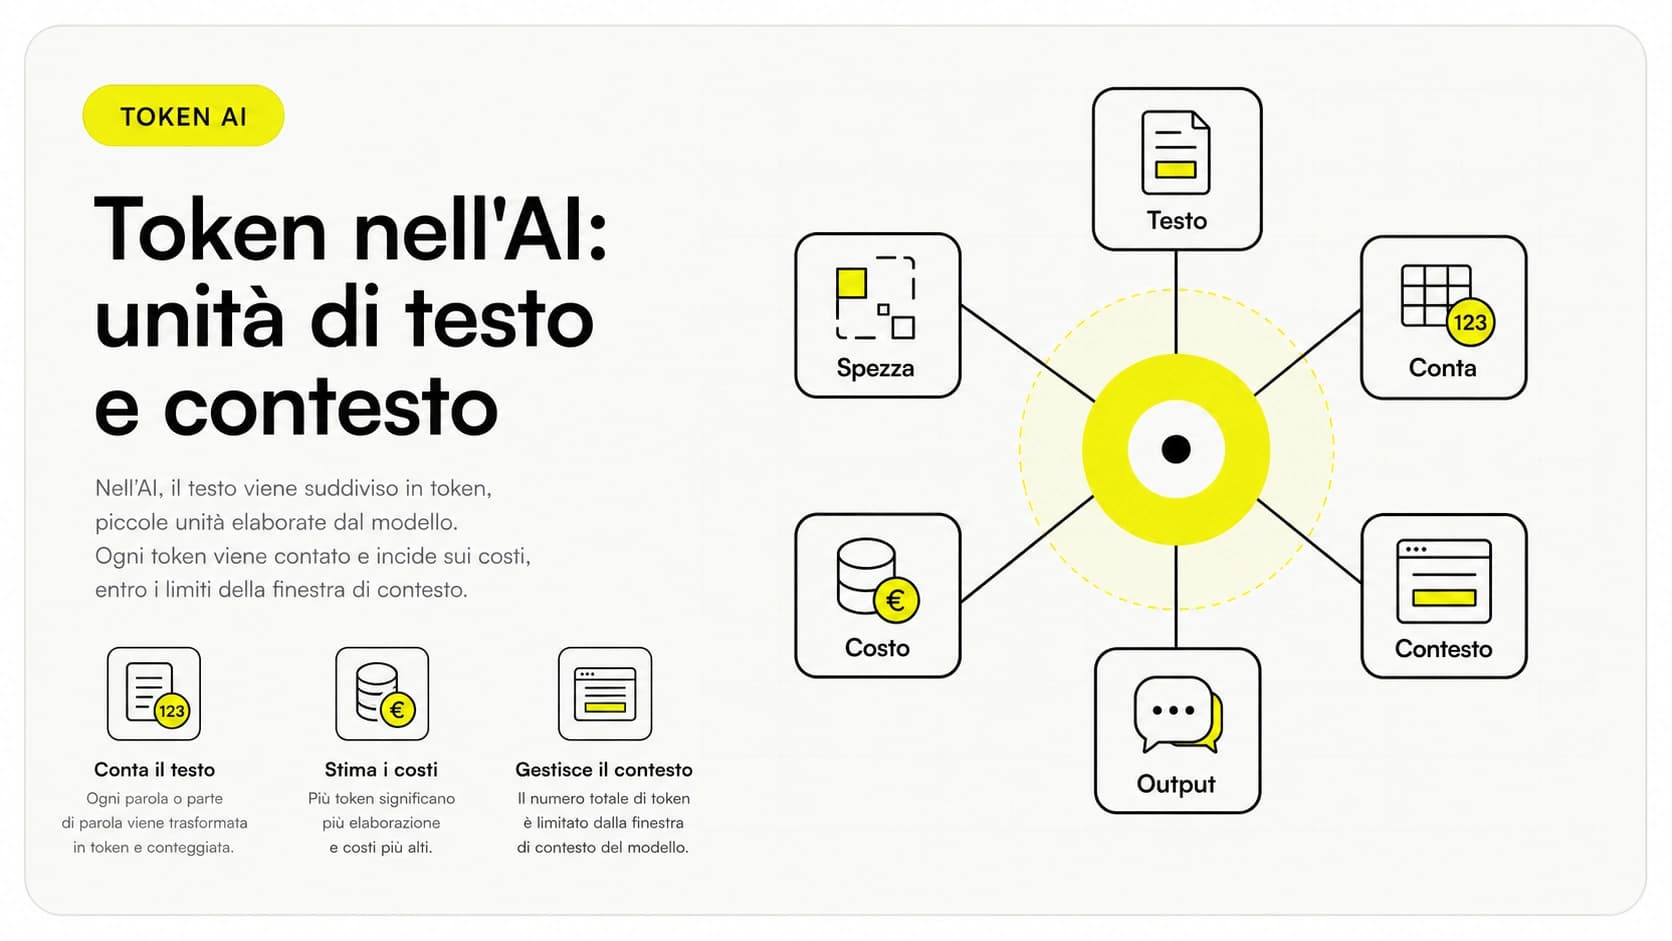
Il punto più utile è il primo: la causa numero uno di lentezza percepita è un prompt troppo lungo, non un modello poco potente. È anche il motivo per cui riempire la finestra di contesto "per sicurezza" è una cattiva idea due volte — vedi cosa sono i token.
Quanto incide il contesto, in pratica
Vale la pena fissare il meccanismo, perché è la leva principale e si capisce in trenta secondi.
Prima di scrivere la prima parola il modello deve leggere tutto quello che gli hai mandato. Questa fase di lettura cresce con la quantità di testo: più materiale alleghi, più tempo passa prima che esca qualcosa. La fase successiva — produrre la risposta — procede invece a un ritmo abbastanza costante.
Ne deriva una regola pratica utile: accorciare il prompt migliora l'attesa iniziale, accorciare la risposta no. Se l'utente si lamenta del tempo prima che compaia qualcosa, chiedere risposte più brevi non serve a niente: bisogna guardare cosa viene mandato.
| Situazione | Effetto sull'attesa iniziale | Effetto sul costo |
|---|---|---|
| Contesto dimezzato | Migliora sensibilmente | Scende |
| Prompt di sistema in cache | Migliora | Scende |
| Risposta più corta | Nessuno | Scende poco |
| Livello di ragionamento più basso | Migliora | Scende |
| Modello più potente | Spesso peggiora | Sale |
L'ultima riga è quella che sorprende di più: il modello migliore è spesso il più lento a partire, perché elabora di più. Su un compito semplice si ottiene un'esperienza peggiore pagando di più — una delle ragioni per cui conviene usare modelli diversi per compiti diversi.
Come si riduce
Interventi efficaci
- Accorciare il contesto: mandare solo le parti pertinenti
- Usare la cache sulla parte di prompt che non cambia mai
- Abbassare il livello di ragionamento dove il compito è semplice
- Attivare lo streaming, così la risposta compare mentre si genera
- Mostrare subito un segnale di attività nell'interfaccia
- Scegliere un modello più leggero per i compiti che non richiedono il migliore
Interventi che servono a poco
- Cambiare fornitore senza aver misurato dove si perde tempo
- Accorciare la risposta: agisce sulla generazione, non sull'attesa iniziale
- Passare al modello più potente sperando che sia più veloce
- Ottimizzare la rete quando il collo di bottiglia è il prompt
La cache merita una nota a parte: quando gran parte del prompt è identica a ogni chiamata — istruzioni di sistema, glossario aziendale, esempi — riutilizzarla invece di rielaborarla riduce sia l'attesa sia il costo. È la singola ottimizzazione con il miglior rapporto fra fatica e risultato in quasi tutti i sistemi in produzione.
Quando invece non conta
In un processo automatico che gira di notte su tremila documenti, nessuno sta guardando. Lì il tempo al primo token è irrilevante e contano altre due cose: il costo per compito e il tempo totale del lotto.
È una distinzione che vale la pena fare presto, perché porta a scelte opposte: per l'interfaccia interattiva conviene un modello reattivo, per il lotto notturno conviene il più economico che superi la soglia di qualità. Spesso la risposta giusta è usarli entrambi, ciascuno dove rende — vedi quando basta un modello economico.
Come si misura
Serve poco, ma va fatto sui dati veri.
- Registra l'istante dell'invio e l'istante del primo pezzo ricevuto, per ogni richiesta
- Fallo su traffico reale, non su una richiesta di prova con un prompt corto
- Guarda il valore tipico e i casi peggiori: la media nasconde proprio quelli che fanno arrabbiare gli utenti
- Misura per tipo di richiesta: quelle con molto contesto si comportano diversamente
- Rifai la misura a orari diversi: la coda del fornitore varia nella giornata
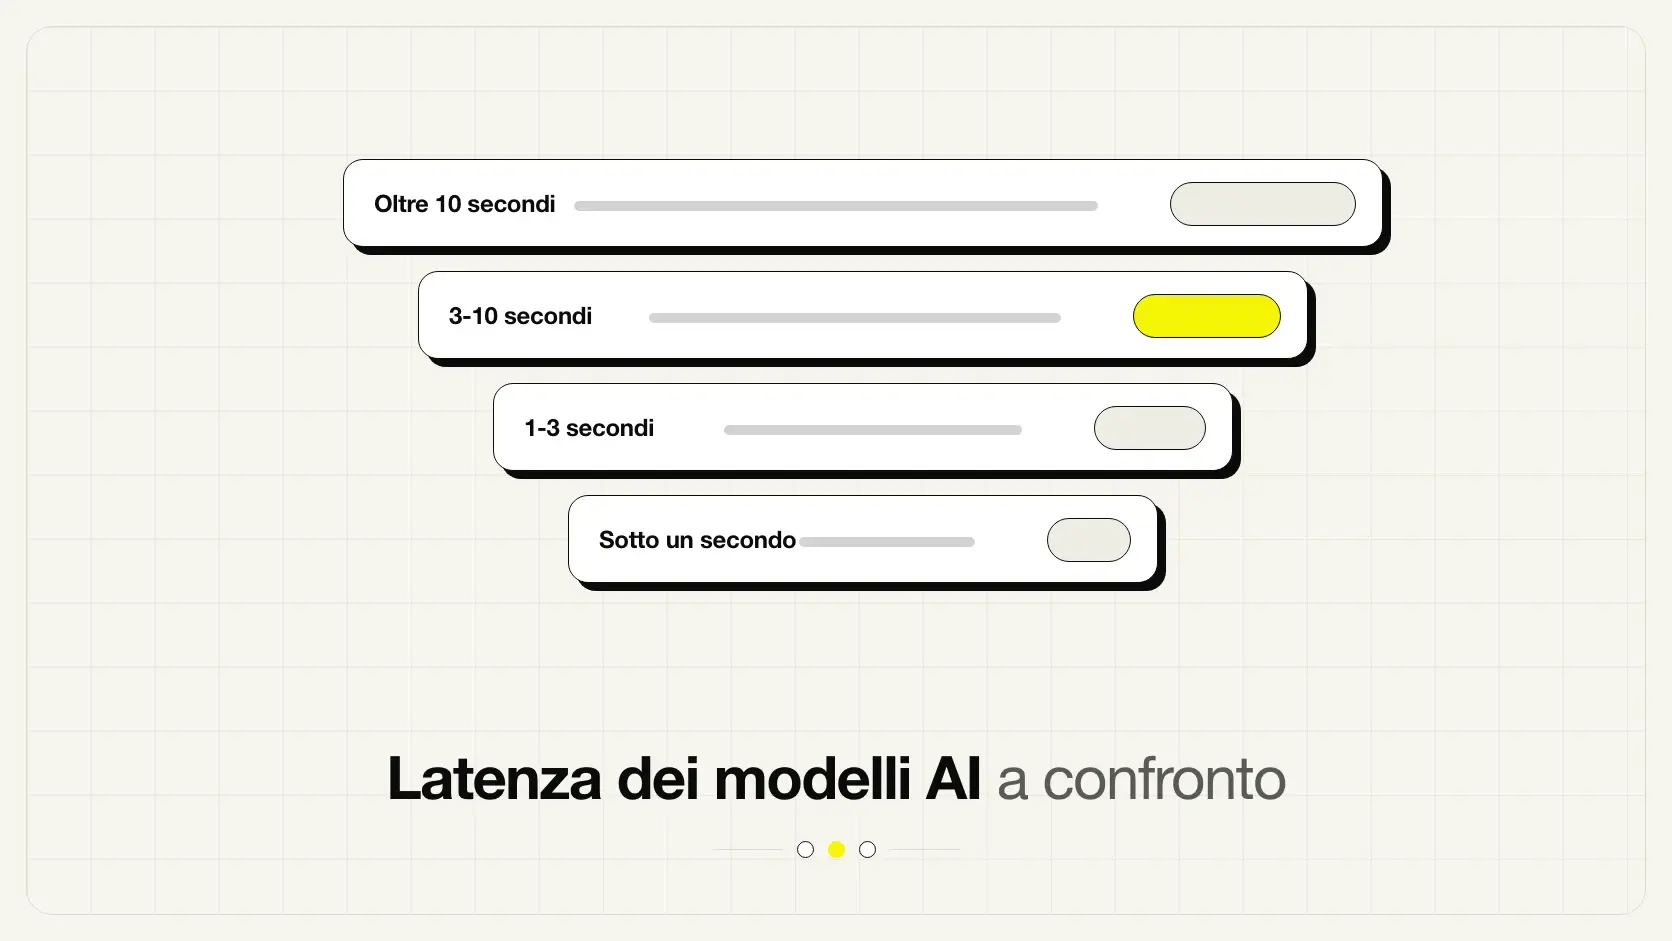
Un errore frequente è misurare una volta sola, di pomeriggio, con un prompt corto, e concludere che il sistema è veloce. Gli utenti sperimenteranno tutt'altro. Per il confronto fra modelli vedi la latenza dei modelli AI.
Esempi pratici
E-commerce con assistente sul sito. L'assistente rispondeva bene ma "sembrava lento" e gli utenti abbandonavano la chat. Misurando si è visto che a ogni domanda venivano allegati l'intero catalogo prodotti e uno storico lungo della conversazione. Ridurre il contesto ai soli prodotti pertinenti e mettere in cache le istruzioni fisse ha tagliato l'attesa iniziale, senza cambiare modello né peggiorare le risposte.
Studio professionale, ricerca su archivio documenti. L'attesa percepita era alta perché prima della risposta il sistema cercava nei documenti, e durante la ricerca l'interfaccia non mostrava nulla. La correzione più efficace non è stata tecnica: è stata mostrare subito che la ricerca era in corso e far comparire la risposta progressivamente. Il tempo reale è cambiato poco, le lamentele sono sparite.
Errori da evitare
- Confondere velocità totale e attesa iniziale. Si ottimizza la cosa sbagliata.
- Non attivare la visualizzazione progressiva. Butta via il vantaggio principale.
- Riempire il contesto "per sicurezza". Si paga due volte, in attesa e in denaro.
- Usare il livello di ragionamento massimo ovunque. Su compiti semplici è attesa regalata.
- Misurare solo la media. I casi peggiori sono quelli che generano le lamentele.
- Applicare le stesse scelte a interfaccia e processi batch. Hanno obiettivi opposti.
Come applicarlo in azienda
Se stai valutando un sistema AI che verrà usato da persone — clienti o colleghi — metti il tempo al primo token fra i criteri di scelta, accanto a qualità e costo. In pratica:
- Distingui gli usi: interfaccia interattiva o elaborazione automatica. I criteri sono diversi.
- Chiedi al fornitore una misura su traffico reale, con valore tipico e casi peggiori, non un numero da brochure.
- Verifica che l'interfaccia mostri la risposta progressivamente. È gratis e cambia la percezione.
- Controlla se il prompt di sistema è in cache. Se non lo è, stai pagando attesa e soldi a ogni chiamata.
Sono quattro domande che chiunque può fare senza competenze tecniche, e che spostano l'esperienza d'uso più di molte scelte apparentemente più importanti. Per come si integra il tutto con i sistemi esistenti vedi l'integrazione dell'AI.
Conclusione
Il tempo al primo token è la metrica che decide se un sistema AI sembra veloce. Non dipende quasi mai dalla potenza del modello: dipende da quanto gli fai leggere prima di rispondere, da quanto ragionamento gli chiedi e da come l'interfaccia gestisce l'attesa.
Prima di cambiare modello perché "è lento", misura dove si perde il tempo. Nella maggior parte dei casi la risposta è un contesto troppo grande, e si risolve senza spendere niente.
L'AI diventa utile quando entra nei processi. Giallo Studio aiuta PMI e team a costruire automazioni concrete, misurabili e sostenibili.
Schema consigliato: Article + FAQPage + BreadcrumbList
Come lo applichiamo in azienda
Risorse correlate
FAQ
Cos'è il tempo al primo token?
È il tempo che passa fra l'invio della richiesta e la comparsa del primo pezzo di risposta. In inglese si abbrevia TTFT, time to first token. Misura quanto l'utente resta davanti a uno schermo fermo.
Perché conta più della velocità totale?
Perché è il tempo di attesa percepito. Con le risposte che compaiono progressivamente, l'utente inizia a leggere appena arriva il primo pezzo: da quel momento la generazione può proseguire mentre lui legge.
Cosa peggiora il tempo al primo token?
Soprattutto la lunghezza di quello che mandi: il modello deve elaborare tutto il prompt prima di produrre la prima parola. Pesano anche il livello di ragionamento richiesto, la distanza geografica del server e la coda quando il servizio è carico.
Come si riduce?
Accorciando il contesto, usando la cache per la parte di prompt che non cambia, abbassando il livello di ragionamento dove non serve e attivando lo streaming della risposta.
Vale anche per i sistemi automatici?
Molto meno. Se nessuno guarda lo schermo, conta il tempo totale e non quello al primo token: in un processo batch è più importante il costo per compito.
Come si misura in pratica?
Si registra l'istante dell'invio e l'istante di arrivo del primo pezzo, su molte richieste reali, e si guarda il valore tipico e i casi peggiori. Una media sola nasconde proprio i casi che fanno arrabbiare gli utenti.